XPath 规则开发
XPath 规则通过请求网页 HTML,定位搜索结果、作品链接、播放线路和剧集入口。本教程以 https://www.dm539.com/ 为例,说明如何从网页结构中得到一套完整规则。
准备工作
- 准备一台可以使用浏览器开发者工具的设备。推荐使用 Windows、macOS 或 Linux 桌面系统,以及最新版 Edge、Chrome 或其他 Chromium 浏览器。
- 安装最新版樱花动漫,依次进入
我的→规则管理→ 右上角+→新建规则。 - 在目标网站中使用任意作品名称执行搜索,确认网站能够直接返回结果。若搜索前必须登录、完成验证码或经过复杂的人机验证,需要额外配置 Cookie 或反爬虫验证,不属于本教程的基础流程。
本文重点说明每个字段的获取方法。完成后的配置汇总在下一篇 XPath 规则示例 中。
规则编辑器界面
新建规则后,可以看到以下编辑界面:
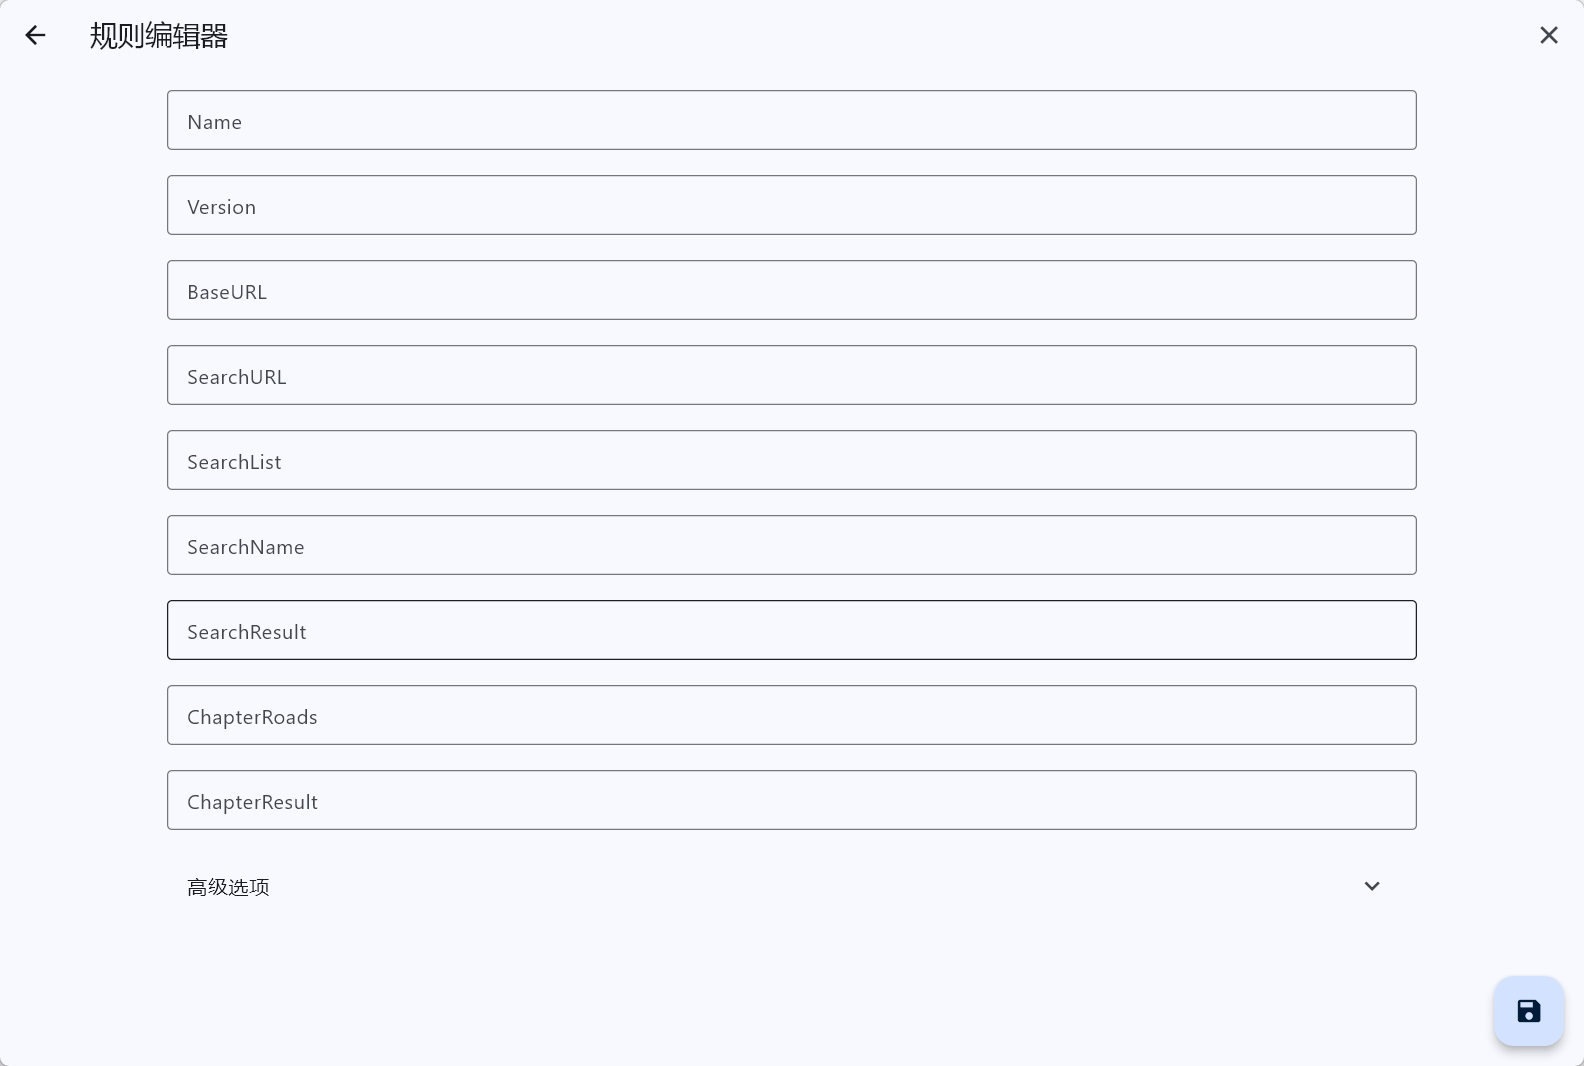
下文按照编辑器字段顺序进行说明。高级选项将在文末单独介绍。
Name
规则名称用于在樱花动漫中识别来源。建议填写网站名称或域名,例如 樱花动漫。
Version
规则版本用于标识配置更新。自用规则没有强制格式;准备提交到规则仓库时,建议从 1.0 开始,并在规则发生变化时递增版本号。
BaseURL
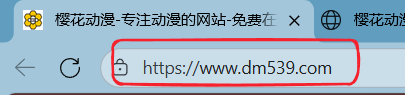
基础地址是网站可以正常访问的根地址。本例填写:
一般可以直接从浏览器地址栏复制网站根地址:
SearchURL
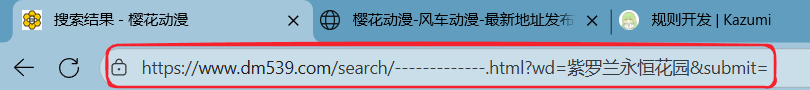
搜索地址是樱花动漫执行关键词检索时请求的 URL。先在目标网站中搜索“紫罗兰永恒花园”,再观察搜索完成后的浏览器地址:
将完整地址复制到规则编辑器:
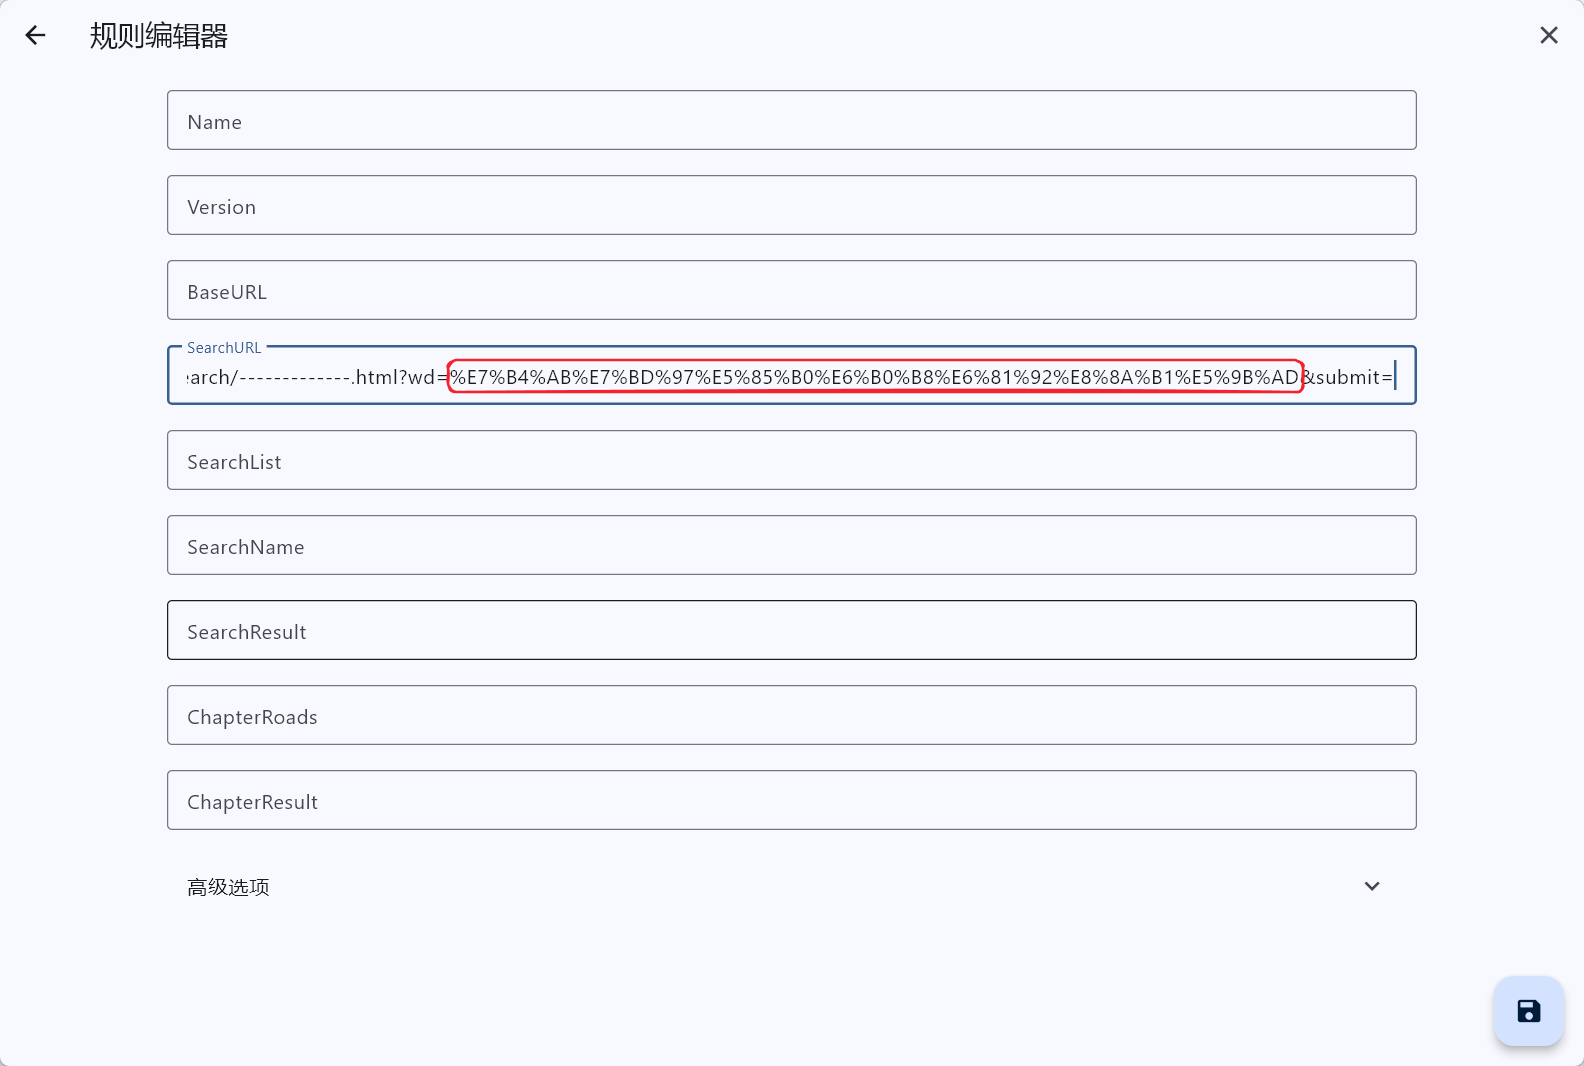
浏览器可能会把中文关键词显示为 URL 编码。无论地址中显示原文还是编码,都需要将关键词对应的部分替换为 @keyword。樱花动漫会在执行搜索时对用户输入的关键词进行编码并替换该变量。
本例最终填写:
本例使用 GET 搜索。对于通过 POST 表单提交关键词的网站,请参考文末的“POST 搜索”部分。
SearchList
SearchList 用于选中搜索结果中的每一个作品条目。从该字段开始,需要借助浏览器开发者工具分析 HTML。
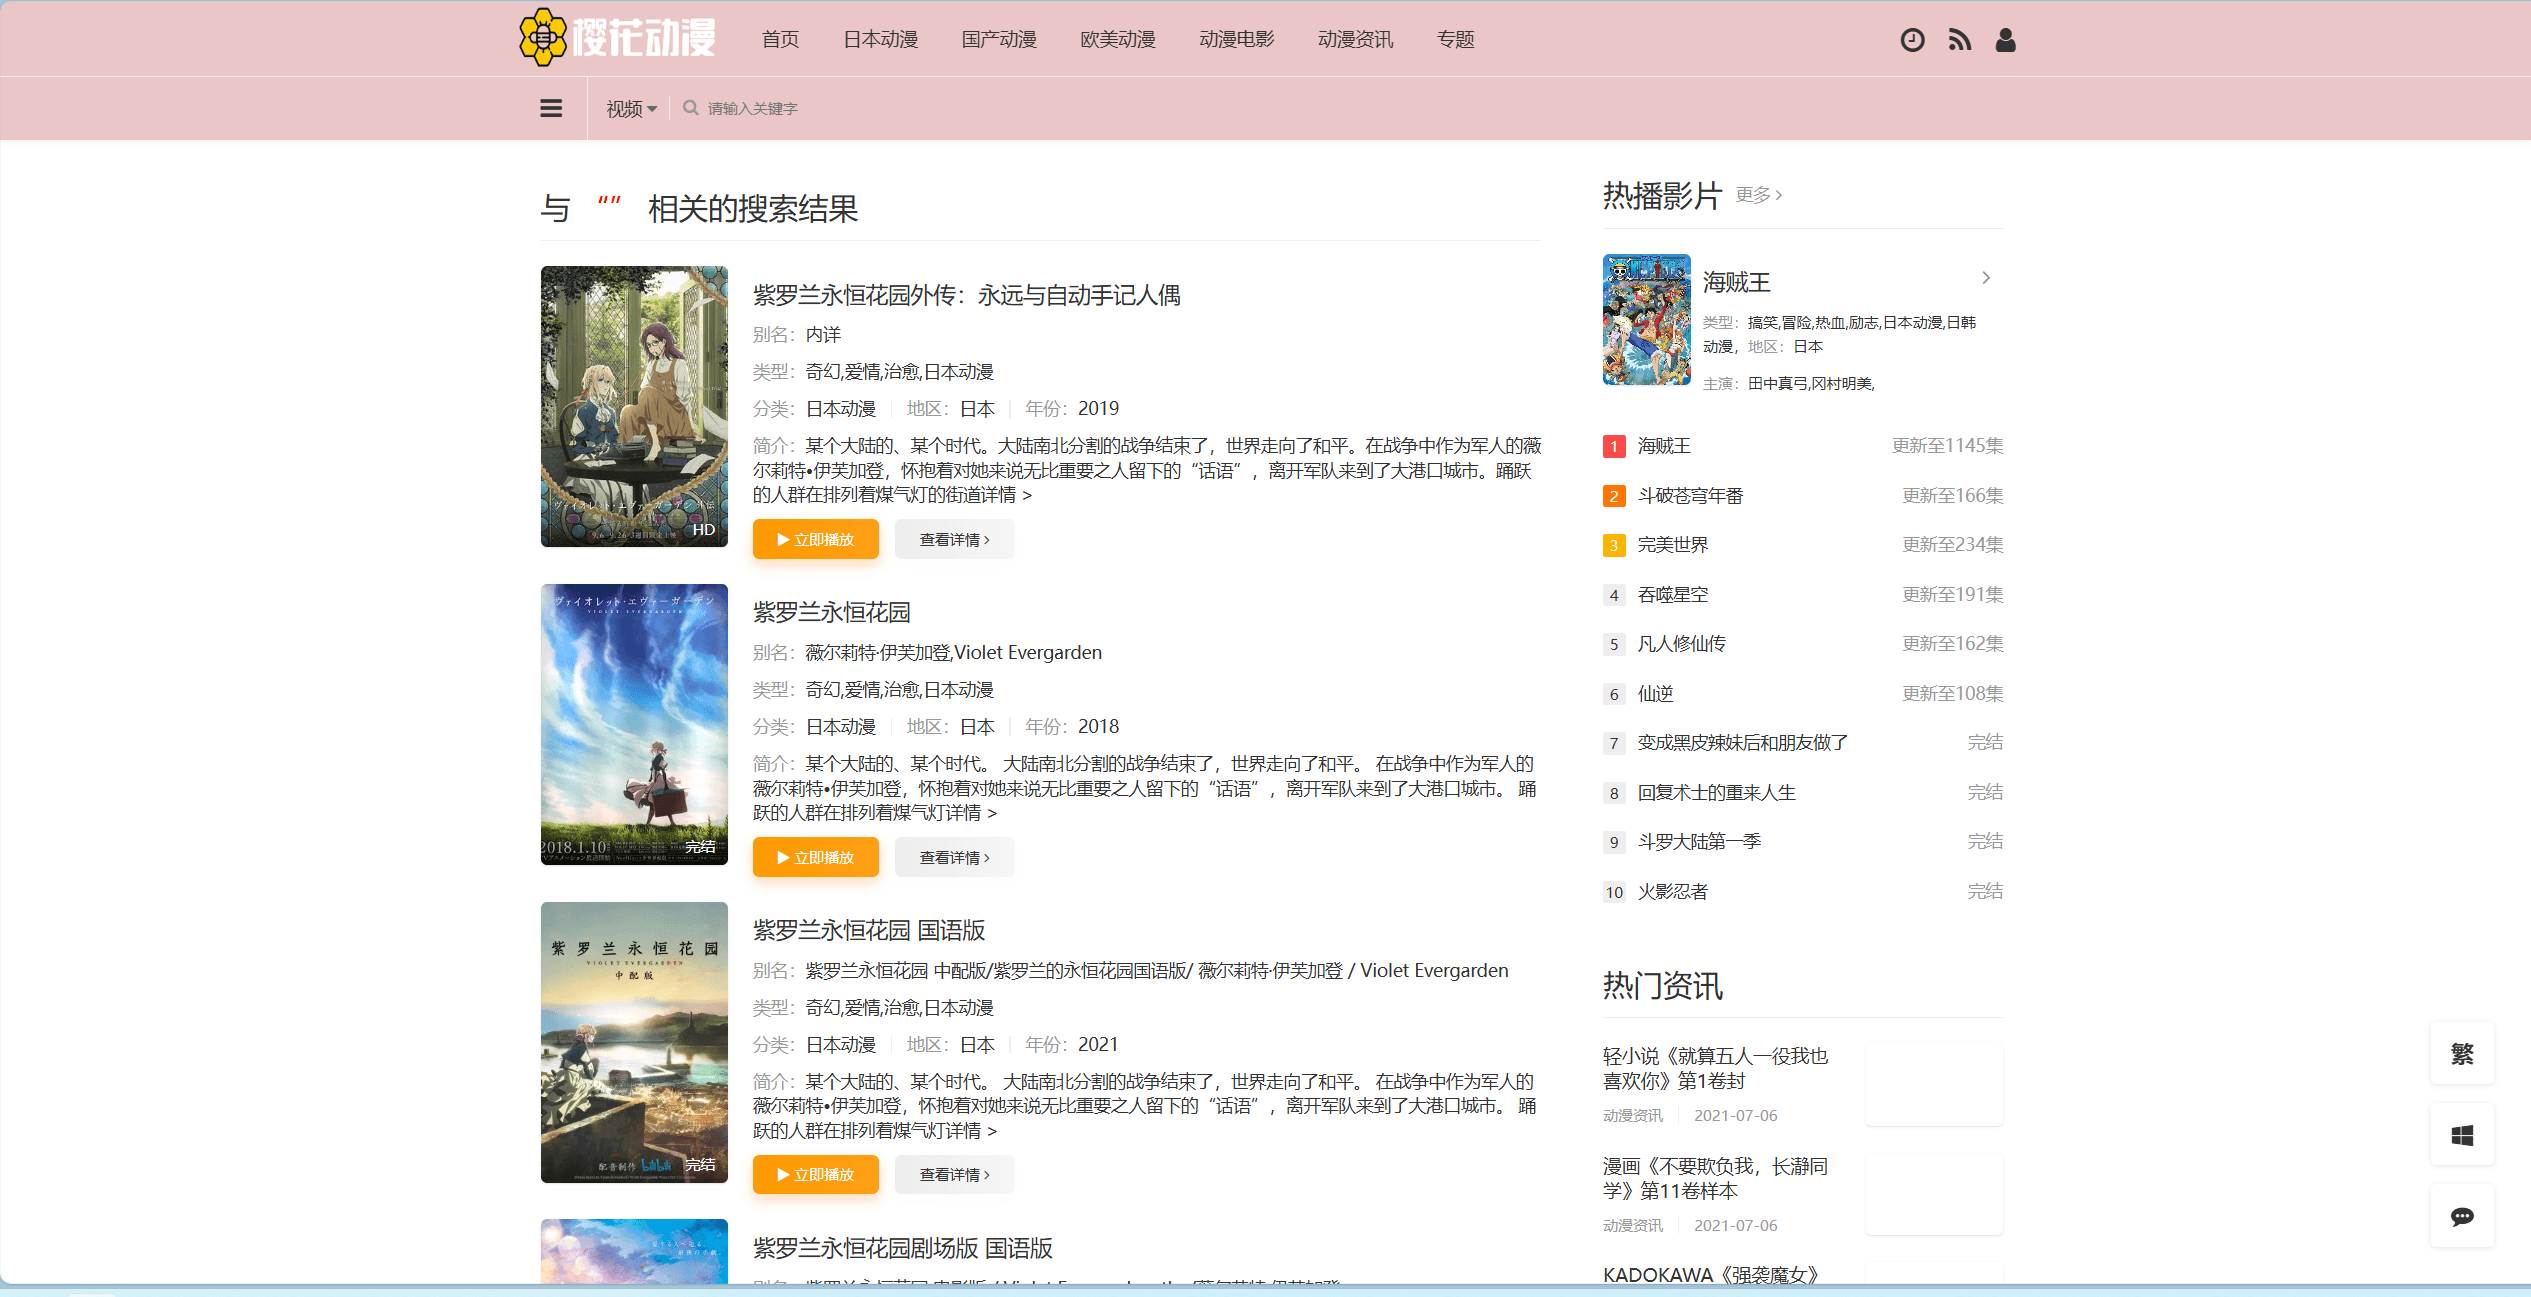
执行搜索后,页面应显示作品列表:
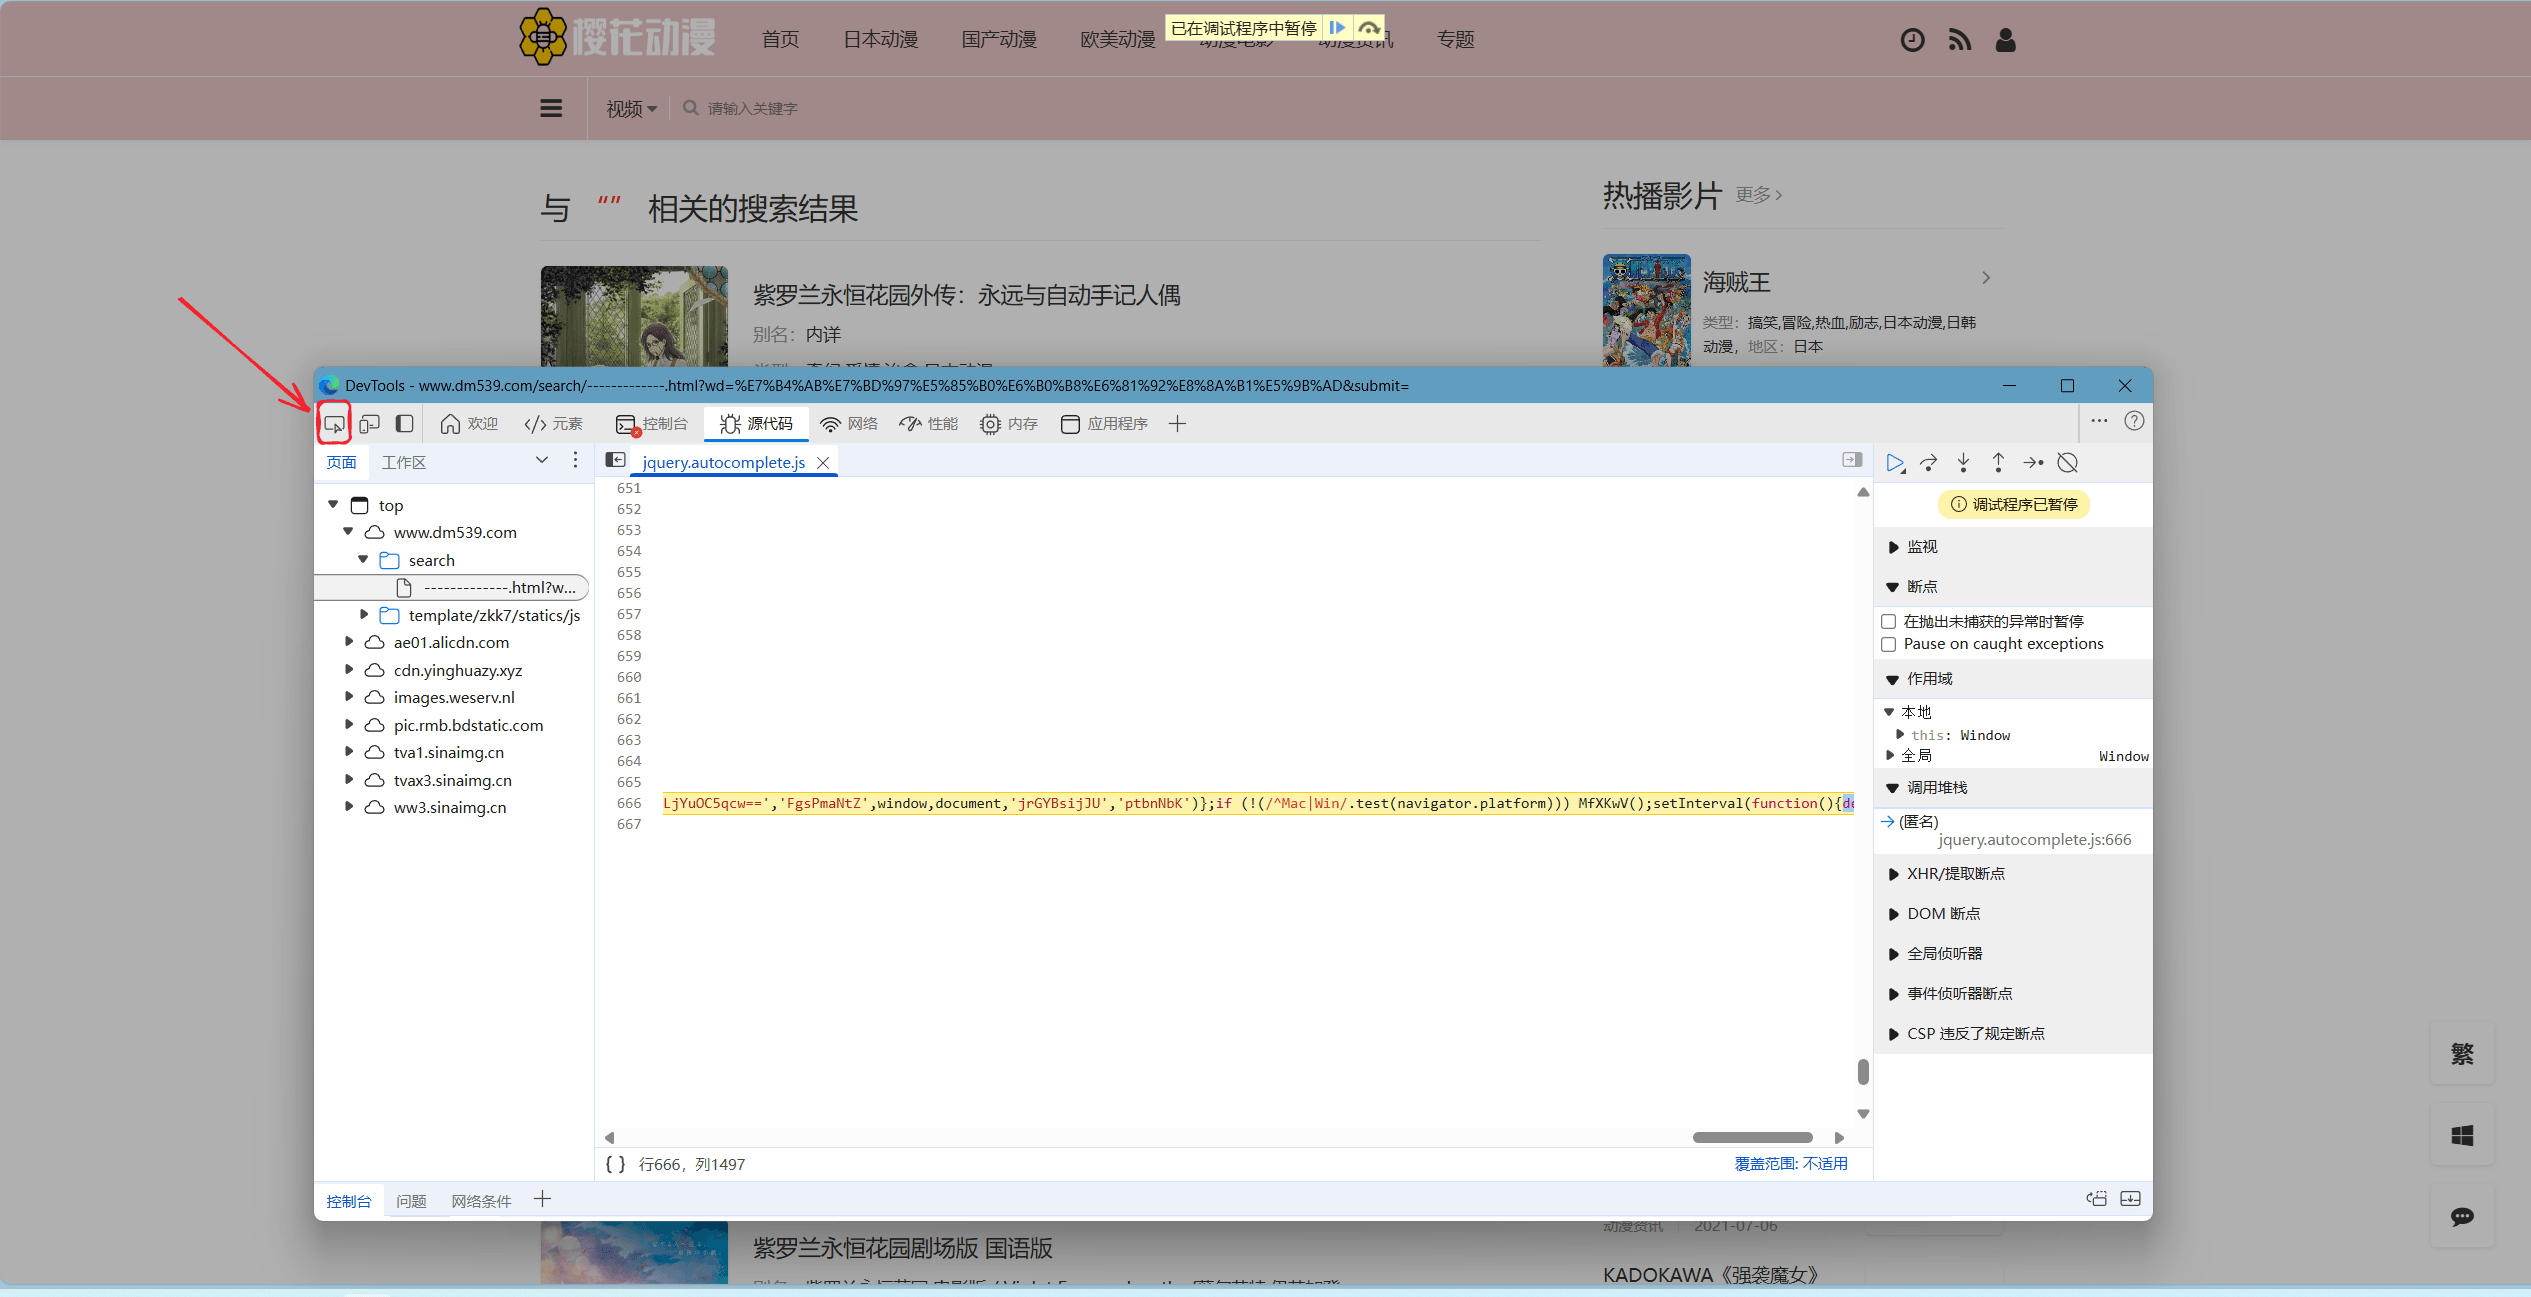
按 F12 打开开发者工具并进入“元素”面板,点击元素选择器:
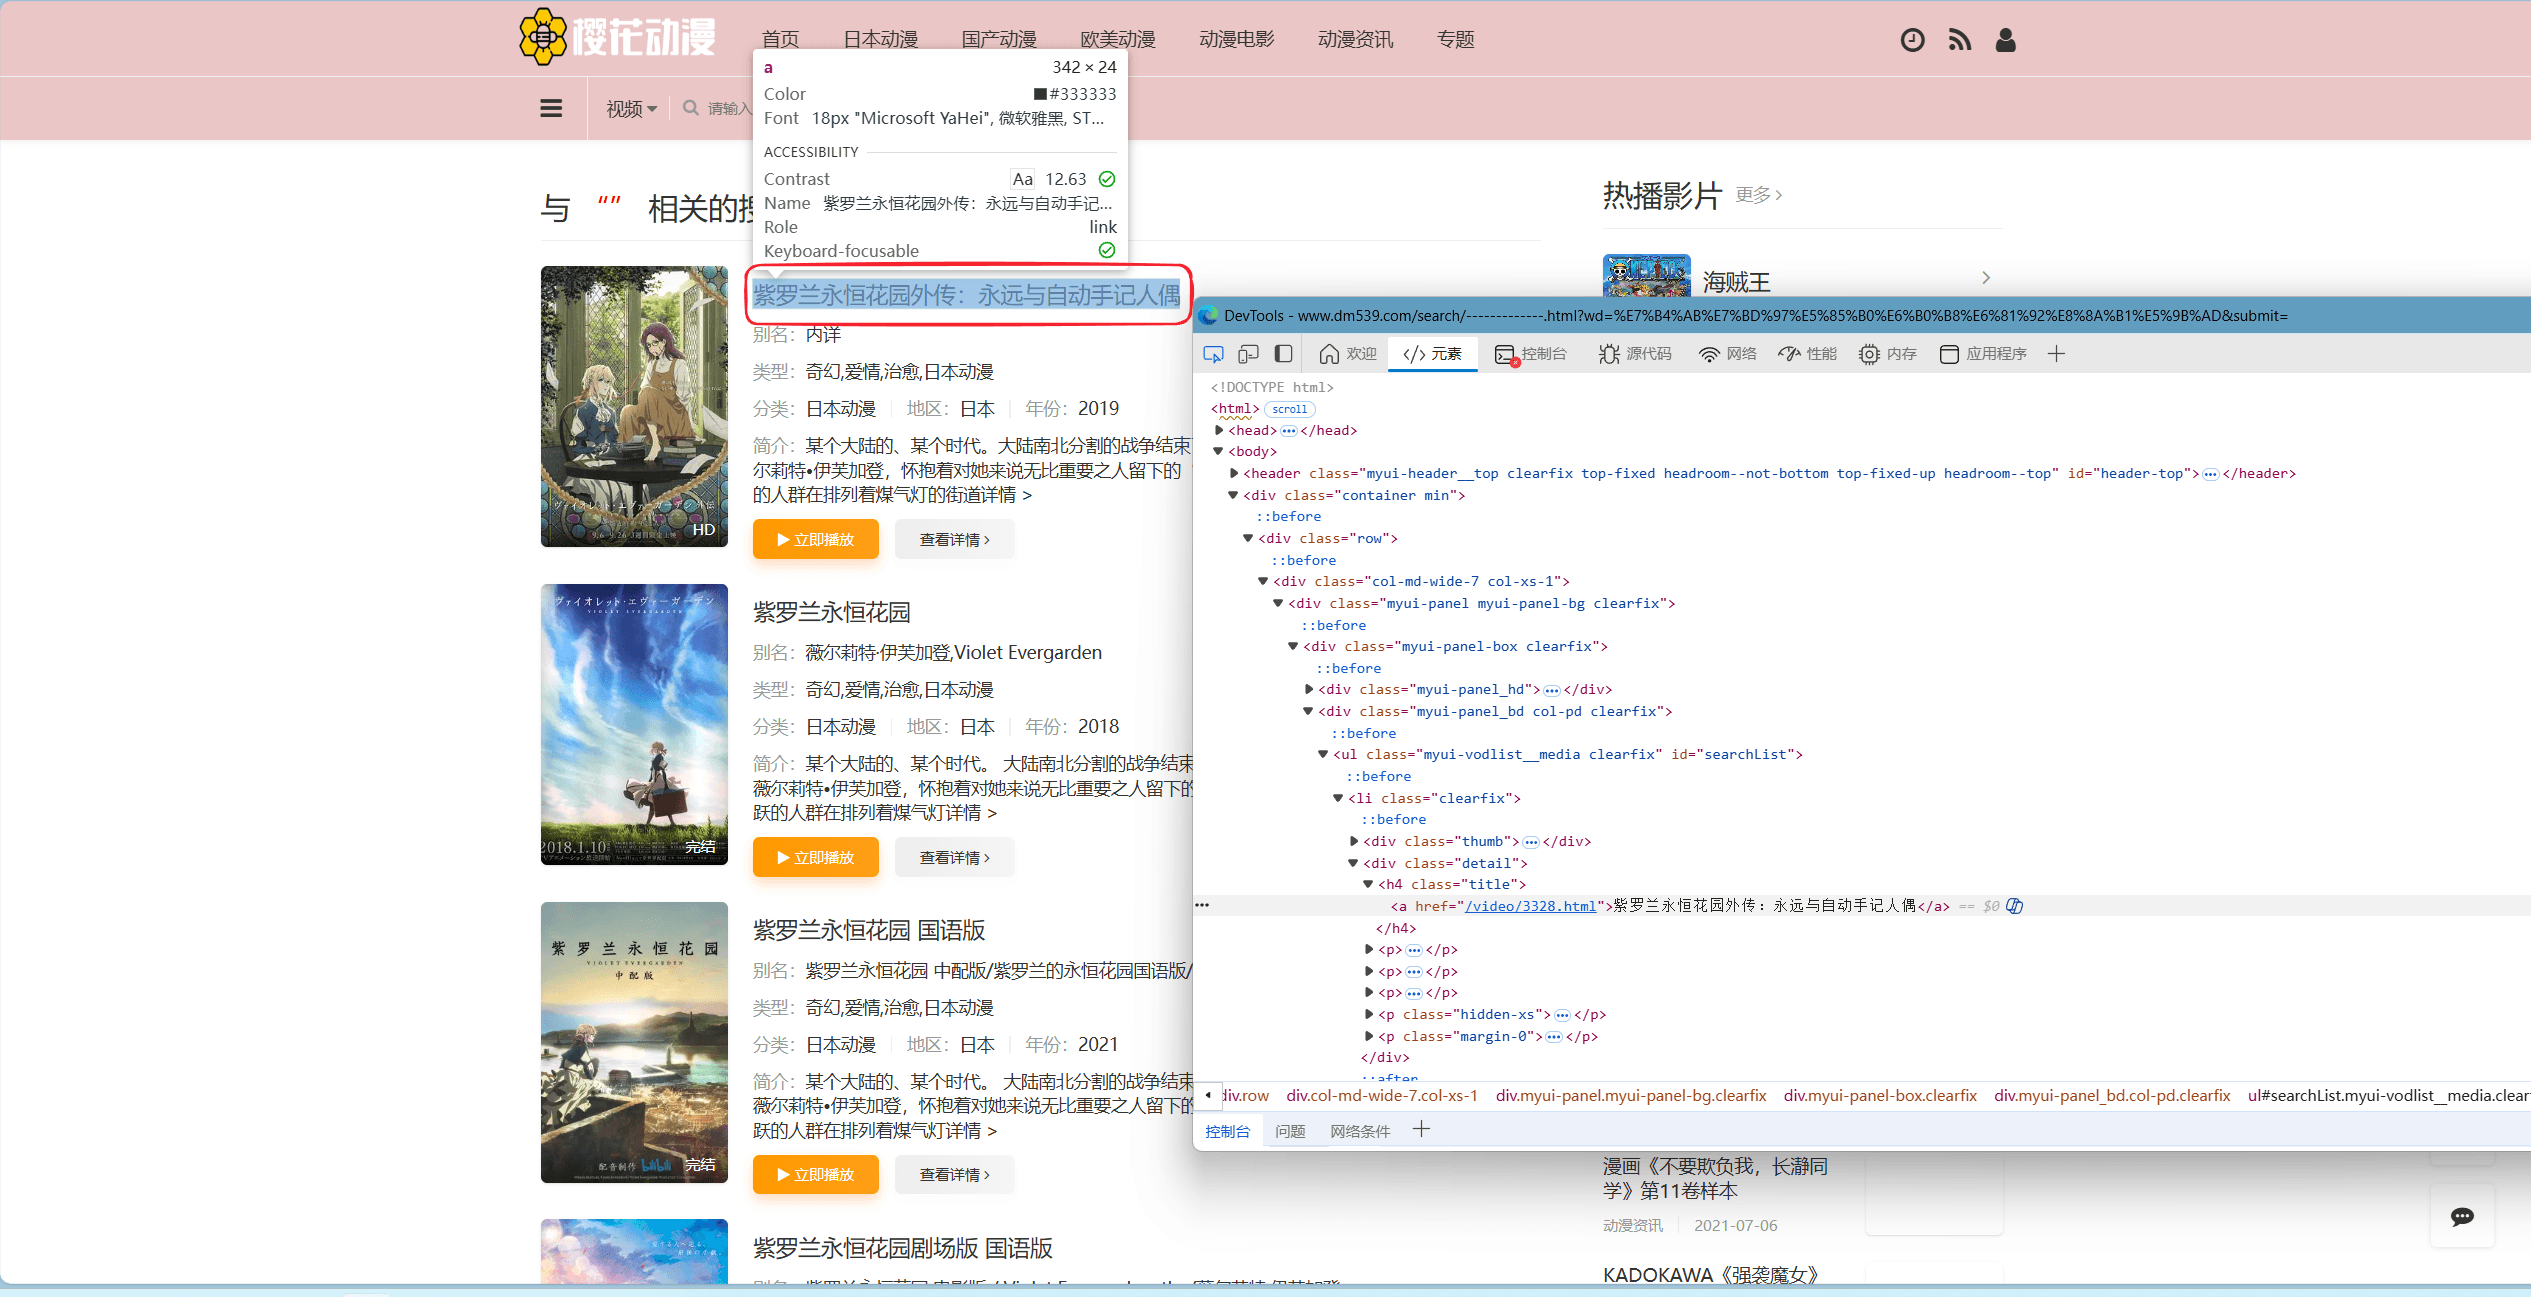
在页面中选择任意作品名称。开发者工具会定位到对应的 HTML 元素:
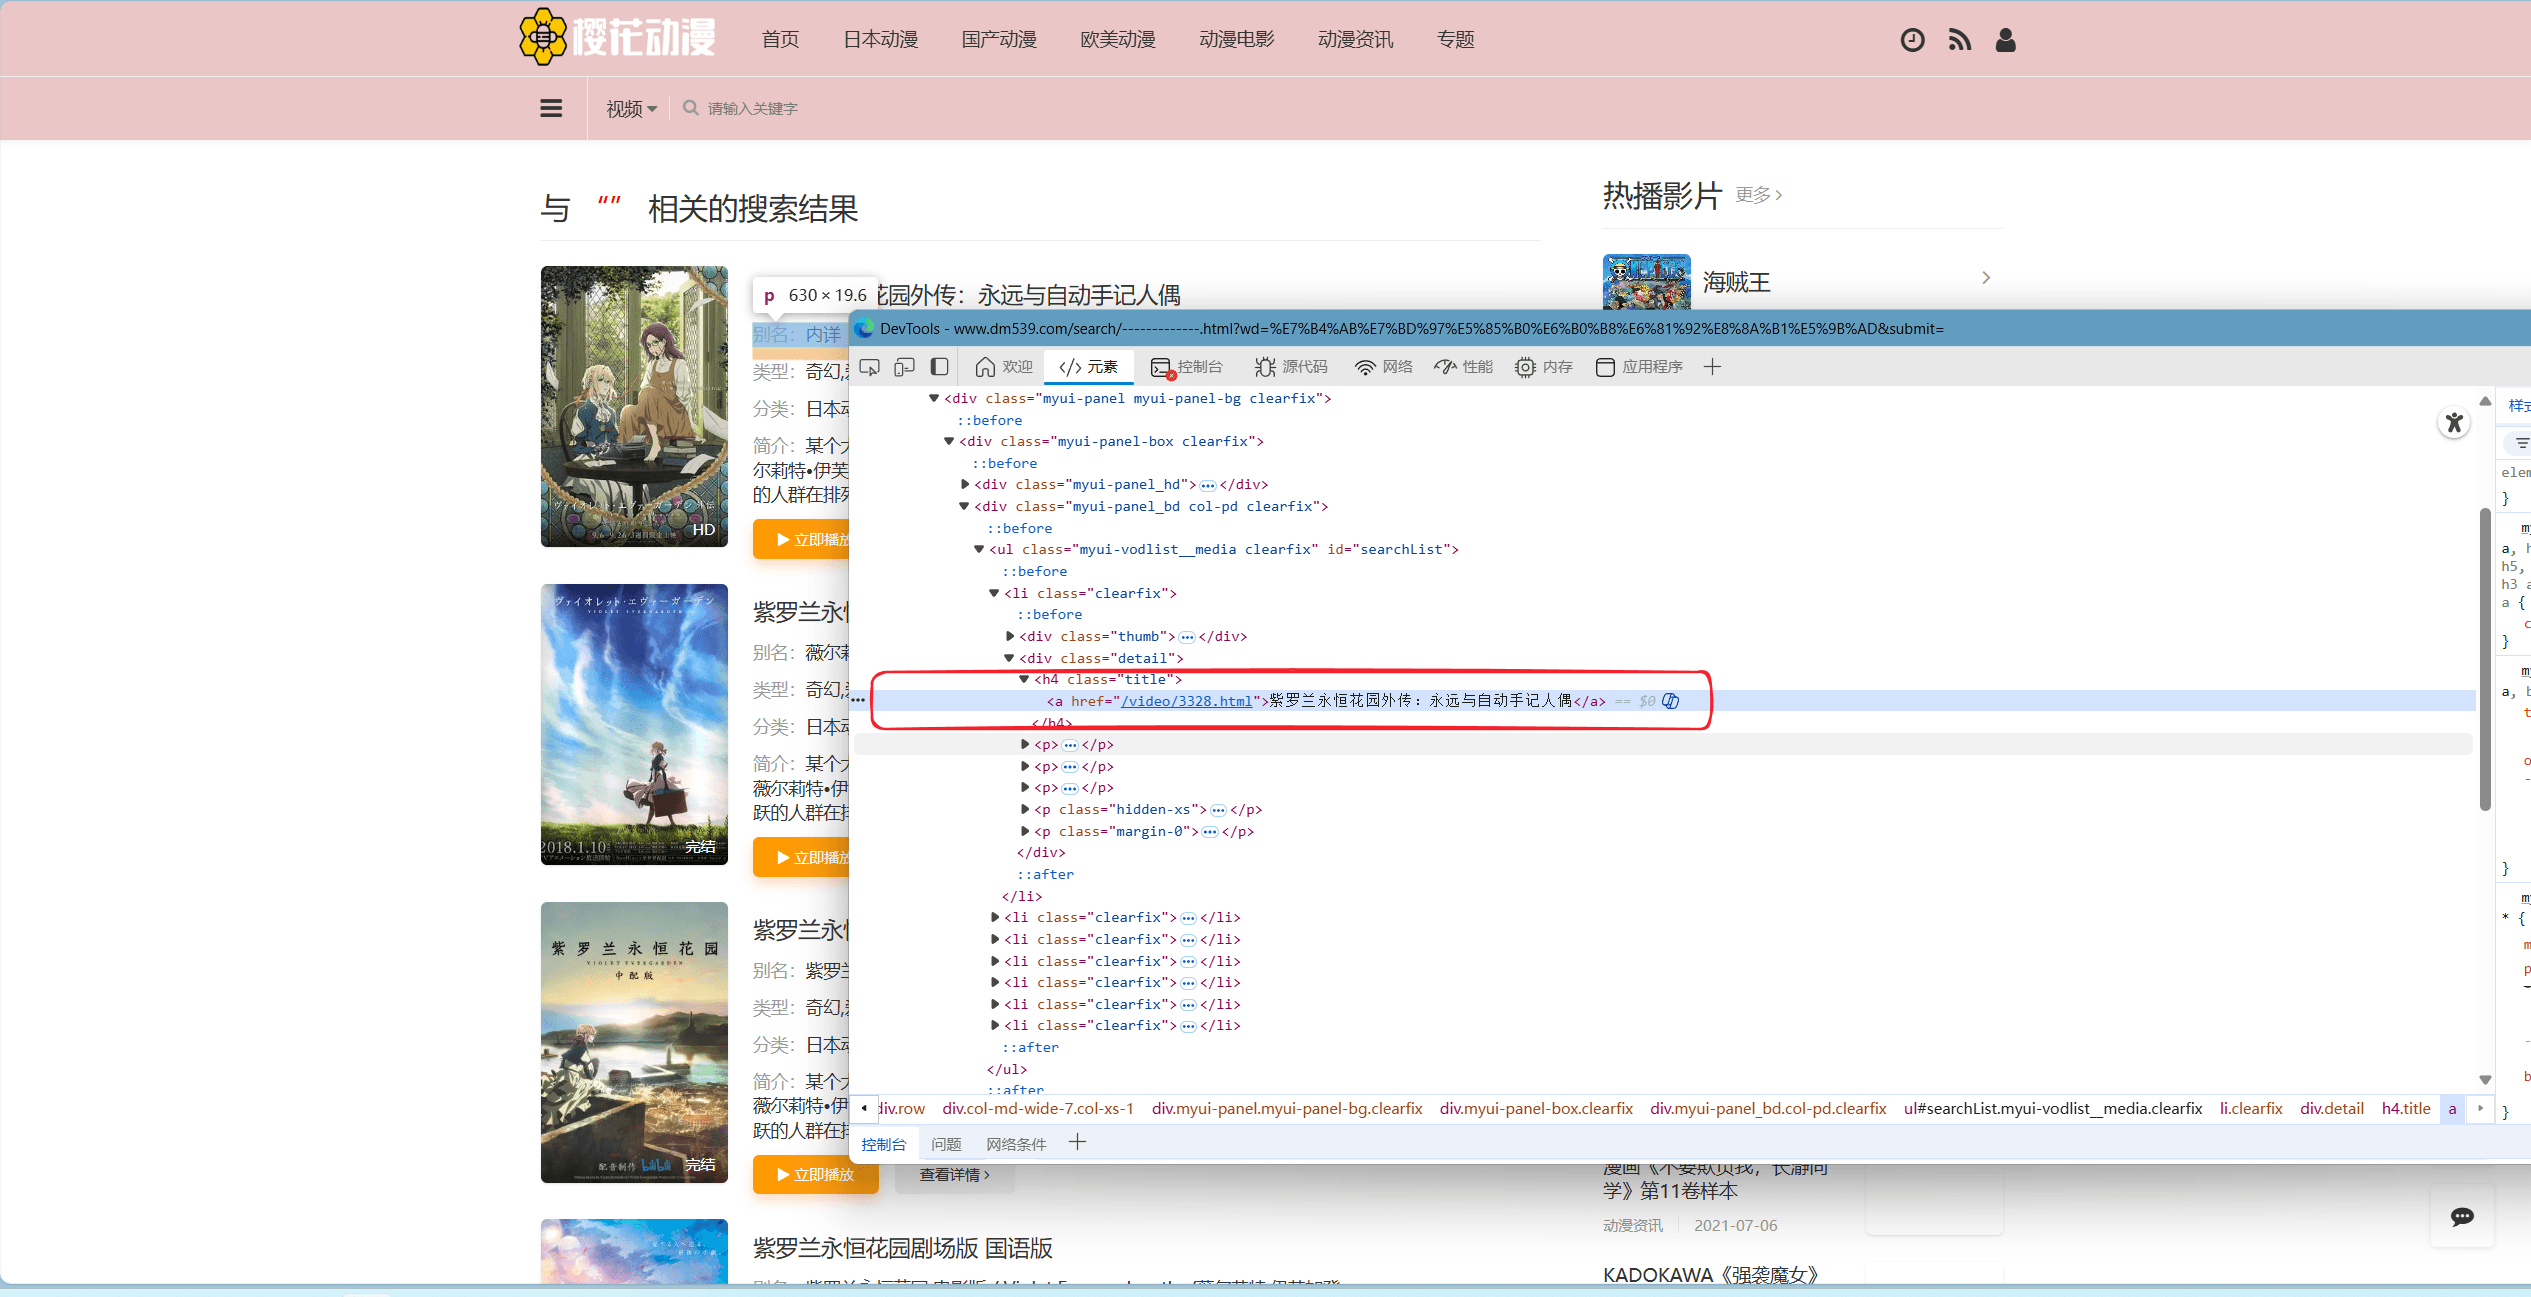
从当前元素逐级向上移动鼠标,观察页面中的高亮范围。当高亮区域覆盖单个搜索结果的全部内容,包括名称和图片时,折叠对应的父元素:
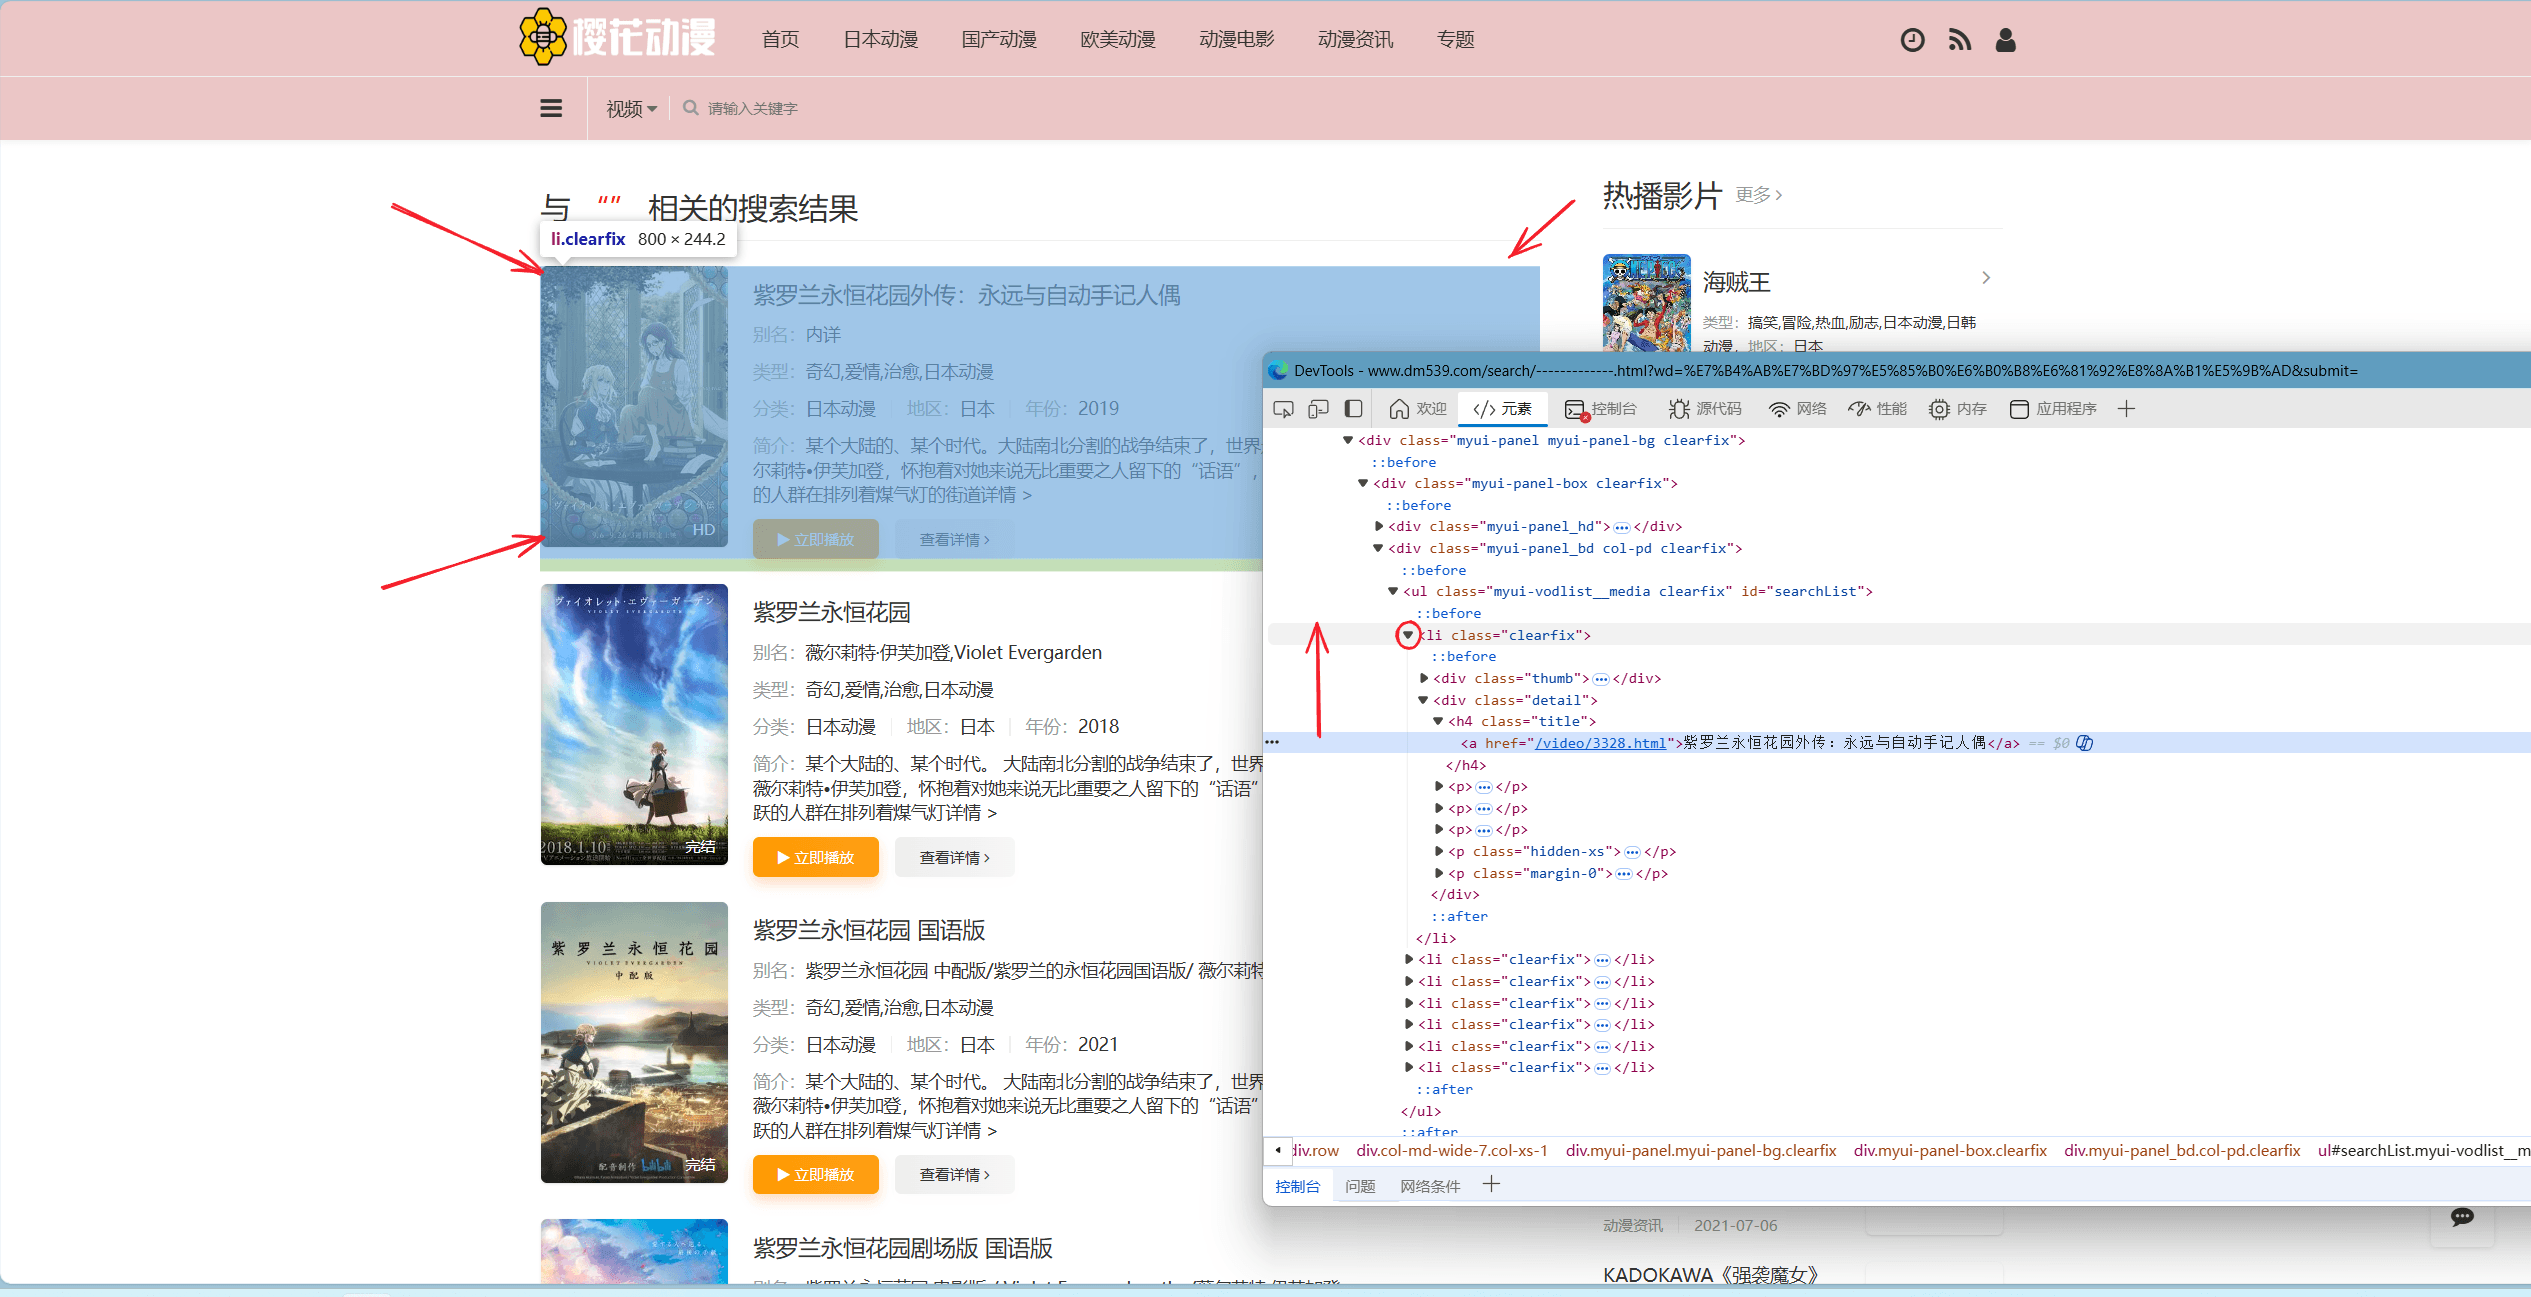
折叠后可以看到多个结构相同的 <li> 元素。元素数量通常与页面中的搜索结果数量一致:
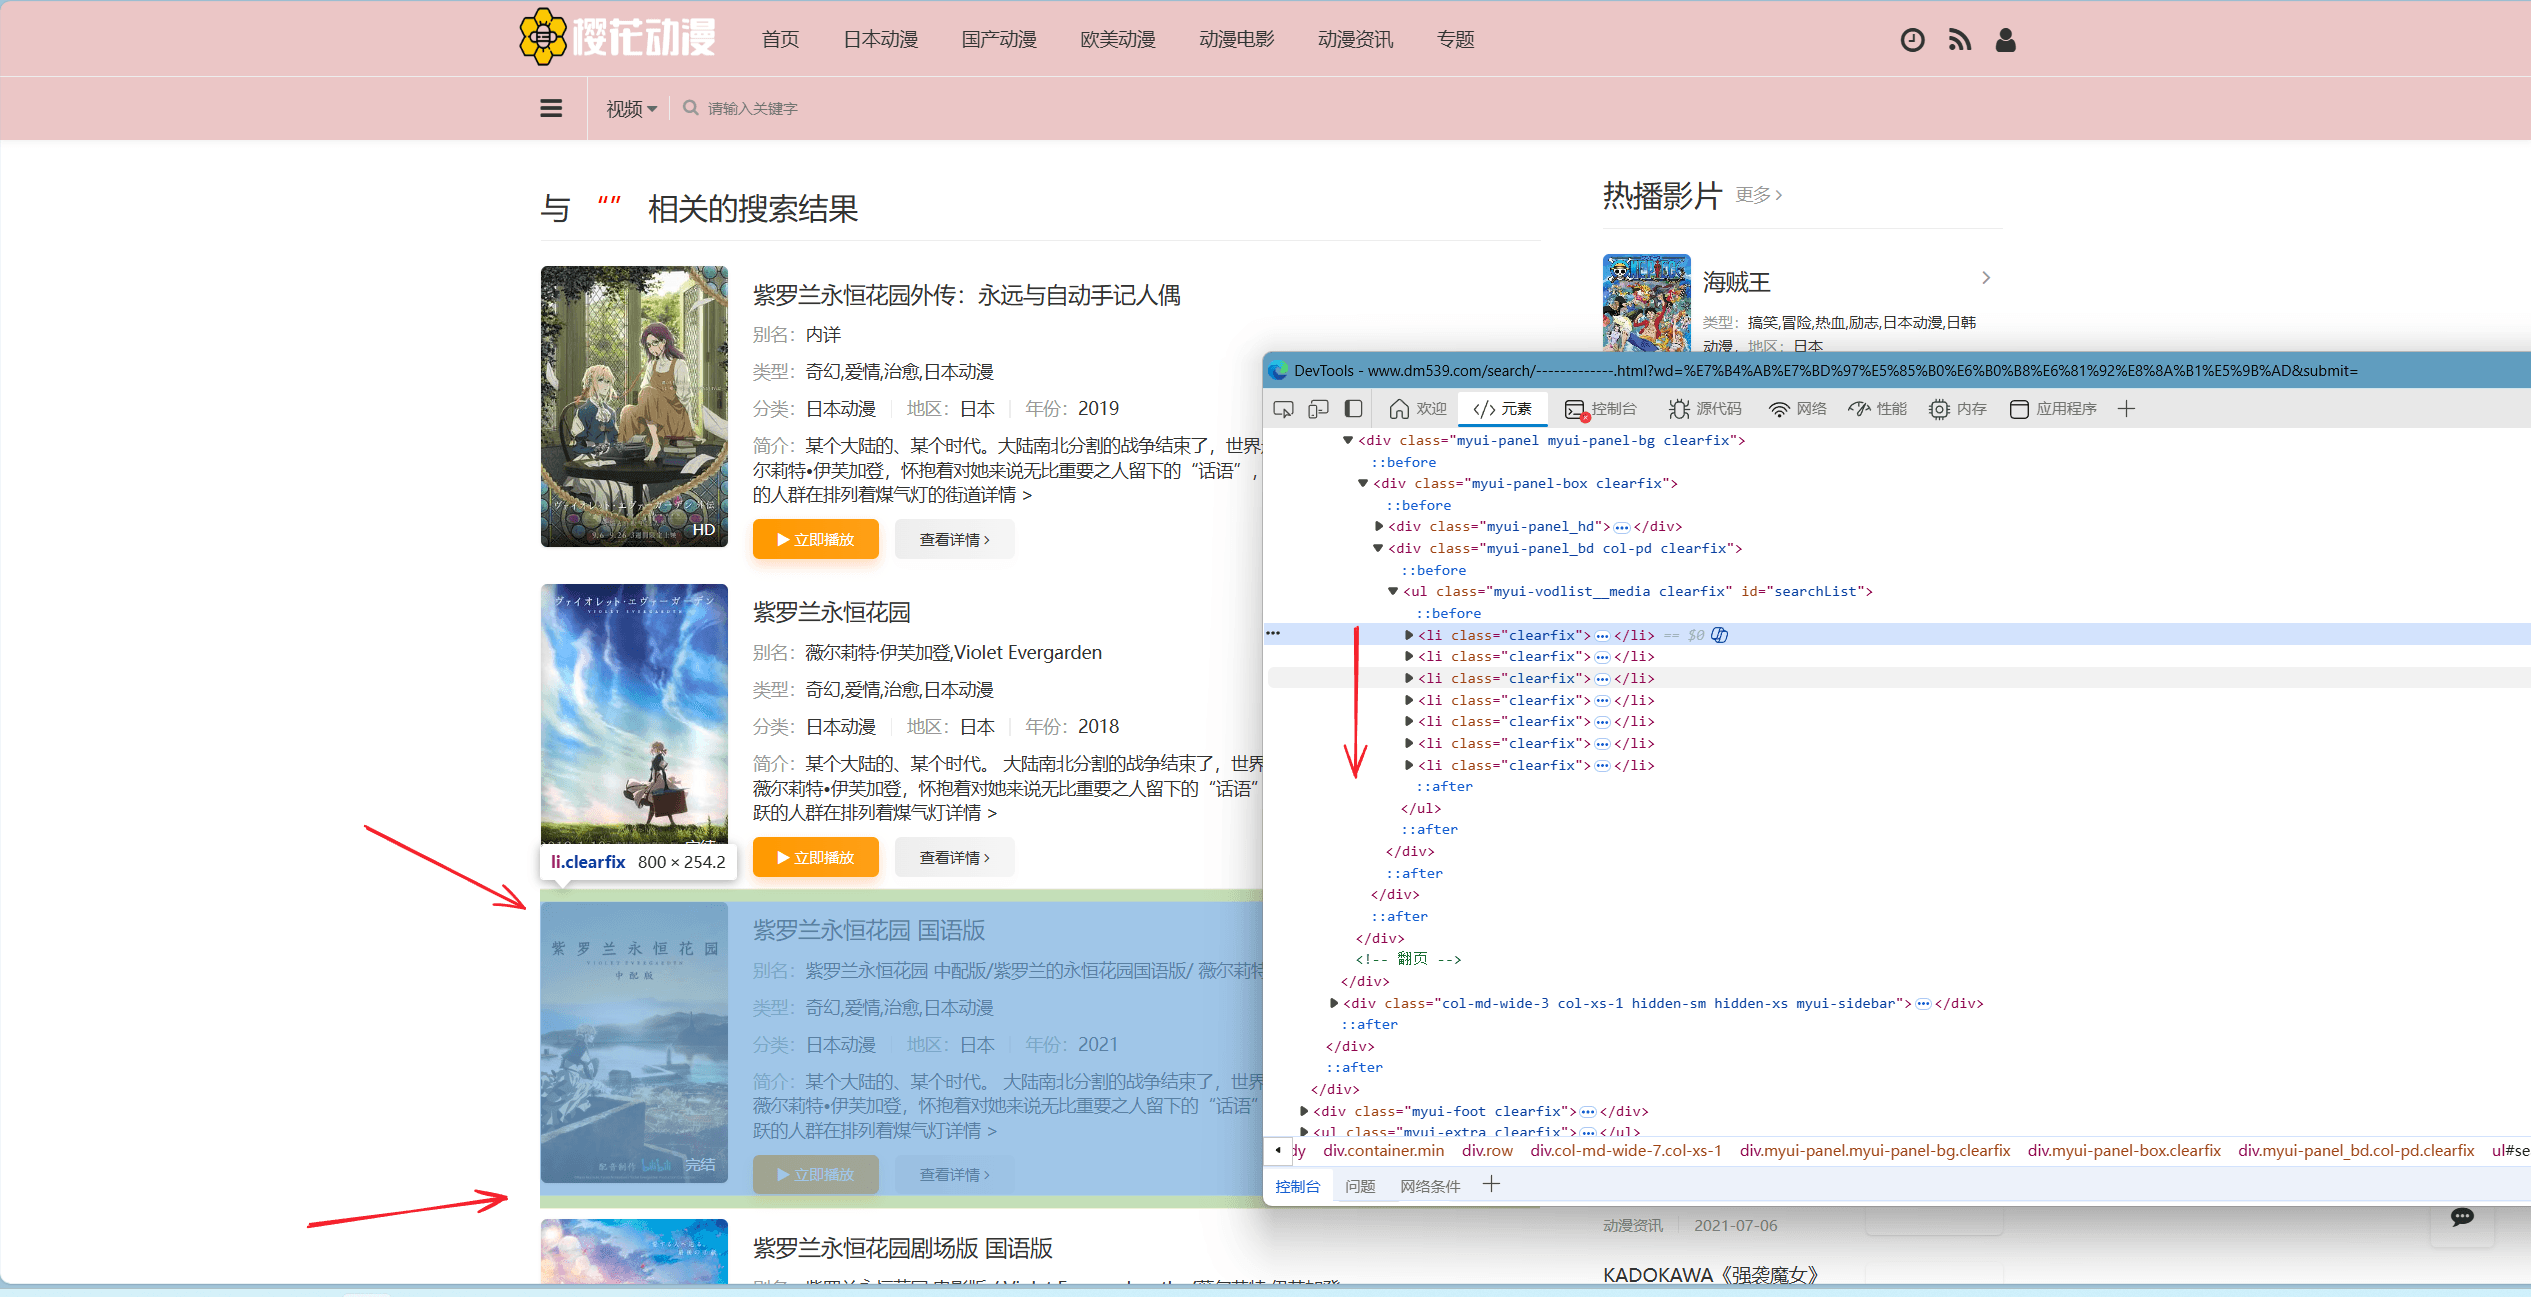
继续向上查找这些 <li> 的公共父元素,直到高亮区域覆盖全部搜索结果。右键该父元素,选择复制完整 XPath:
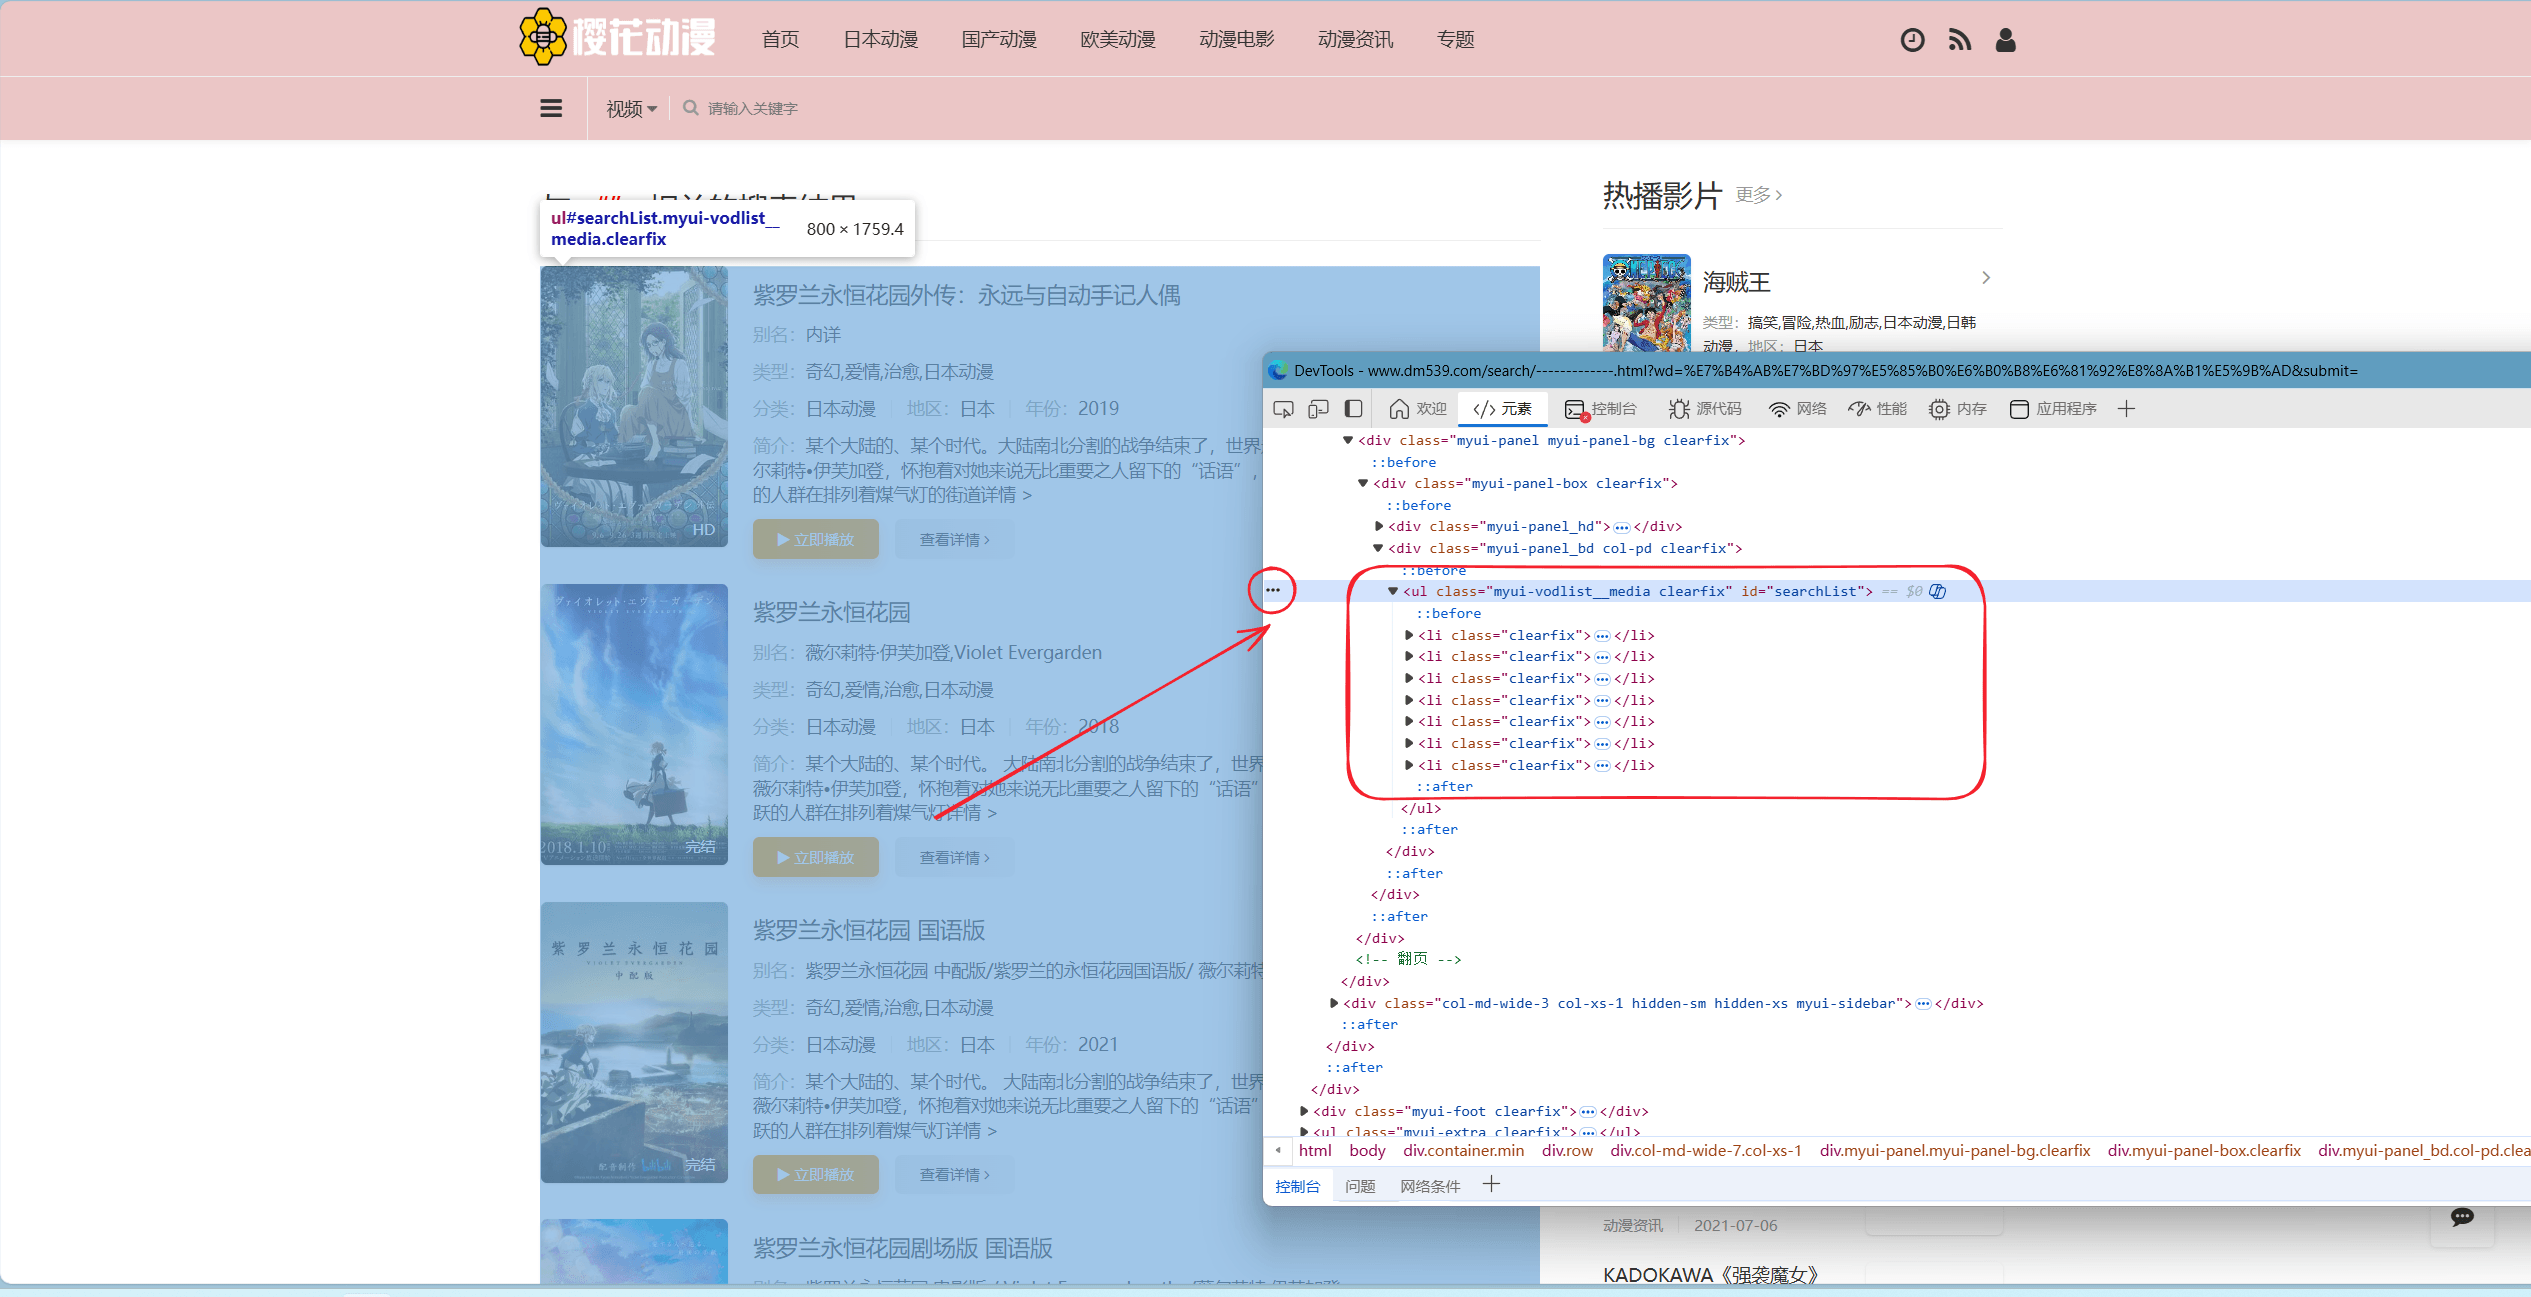
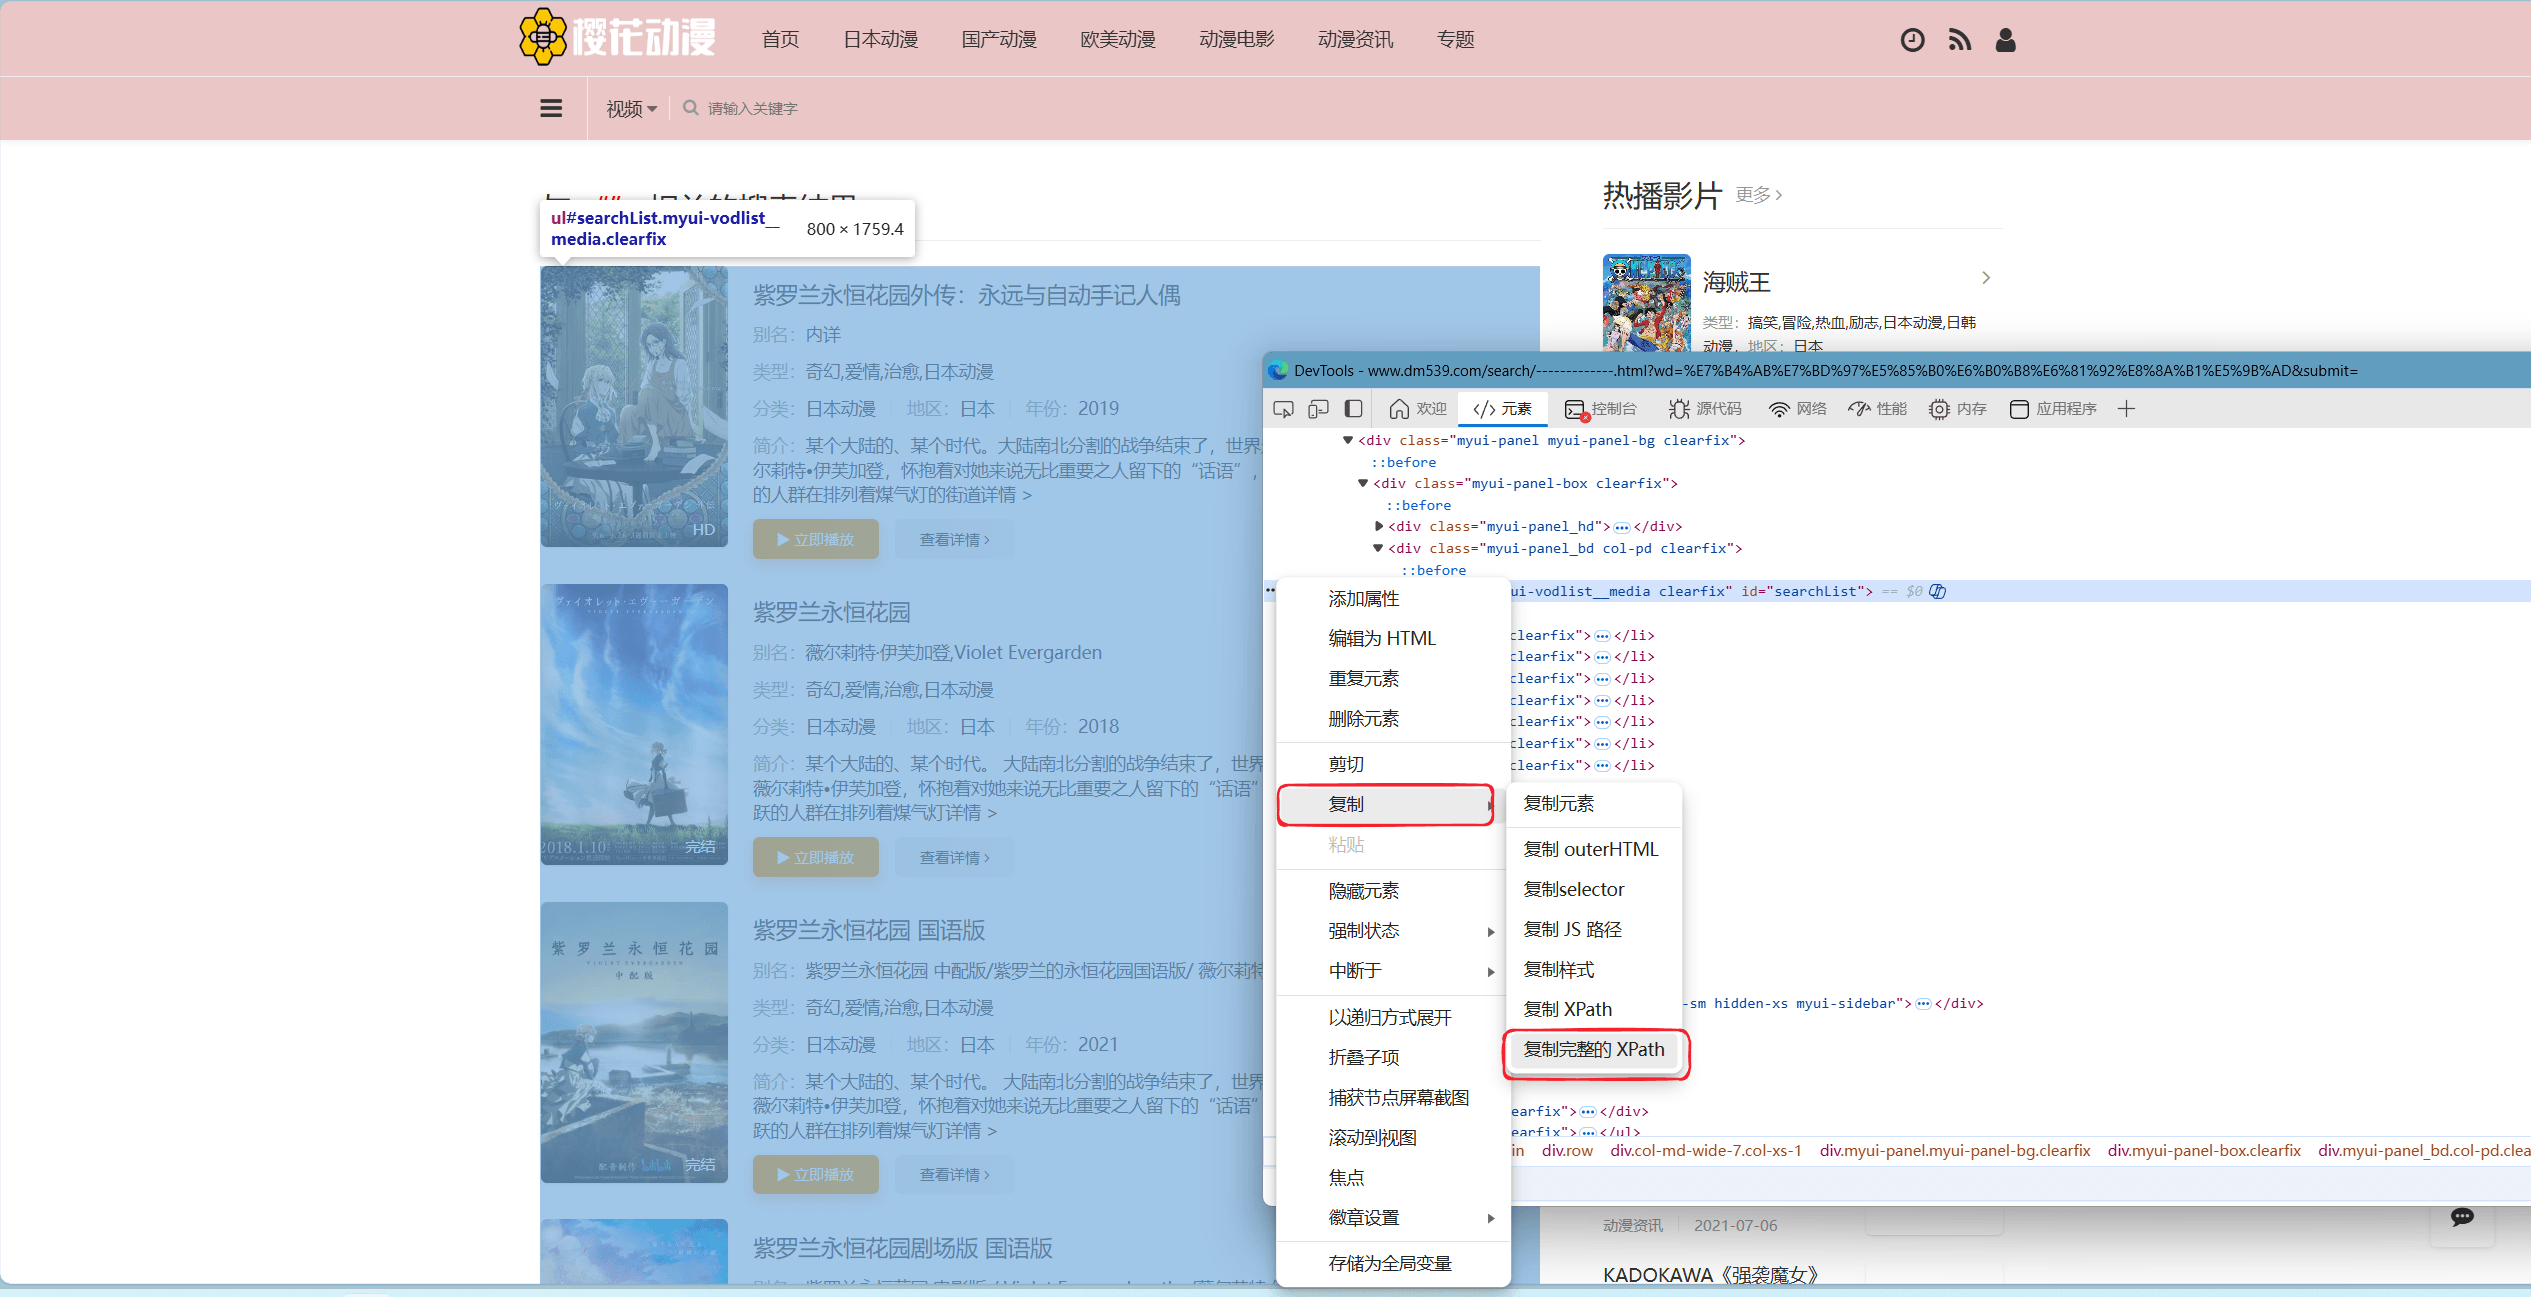
浏览器复制出的 XPath 为:
樱花动漫的 XPath 选择器需要以 // 开头,因此删除 /html/body,得到:
该表达式只定位到列表容器 <ul>。每一个搜索结果都是容器内的 <li>,因此在末尾追加 //li:
这就是本例的 SearchList。
不同网站可能使用 <div>、<article> 或其他元素表示搜索结果,应根据实际 HTML 结构调整末尾的元素名称。
如果元素具有稳定且唯一的属性,可以使用更简洁的选择器。本例的条目结构为 <li class="clearfix">,因此也可以写成:
表达式 //li[@class='clearfix'] 表示选择所有 class 属性等于 clearfix 的 <li> 元素。对于 <div class="clearfix" id="playlist">,可以使用稳定性更高的 id:
SearchName
SearchName 用于从每个 SearchList 条目中提取作品名称。该选择器以单个搜索结果为起点,因此只填写条目内部的相对路径。
使用元素选择器定位第一个作品名称,并复制完整 XPath:
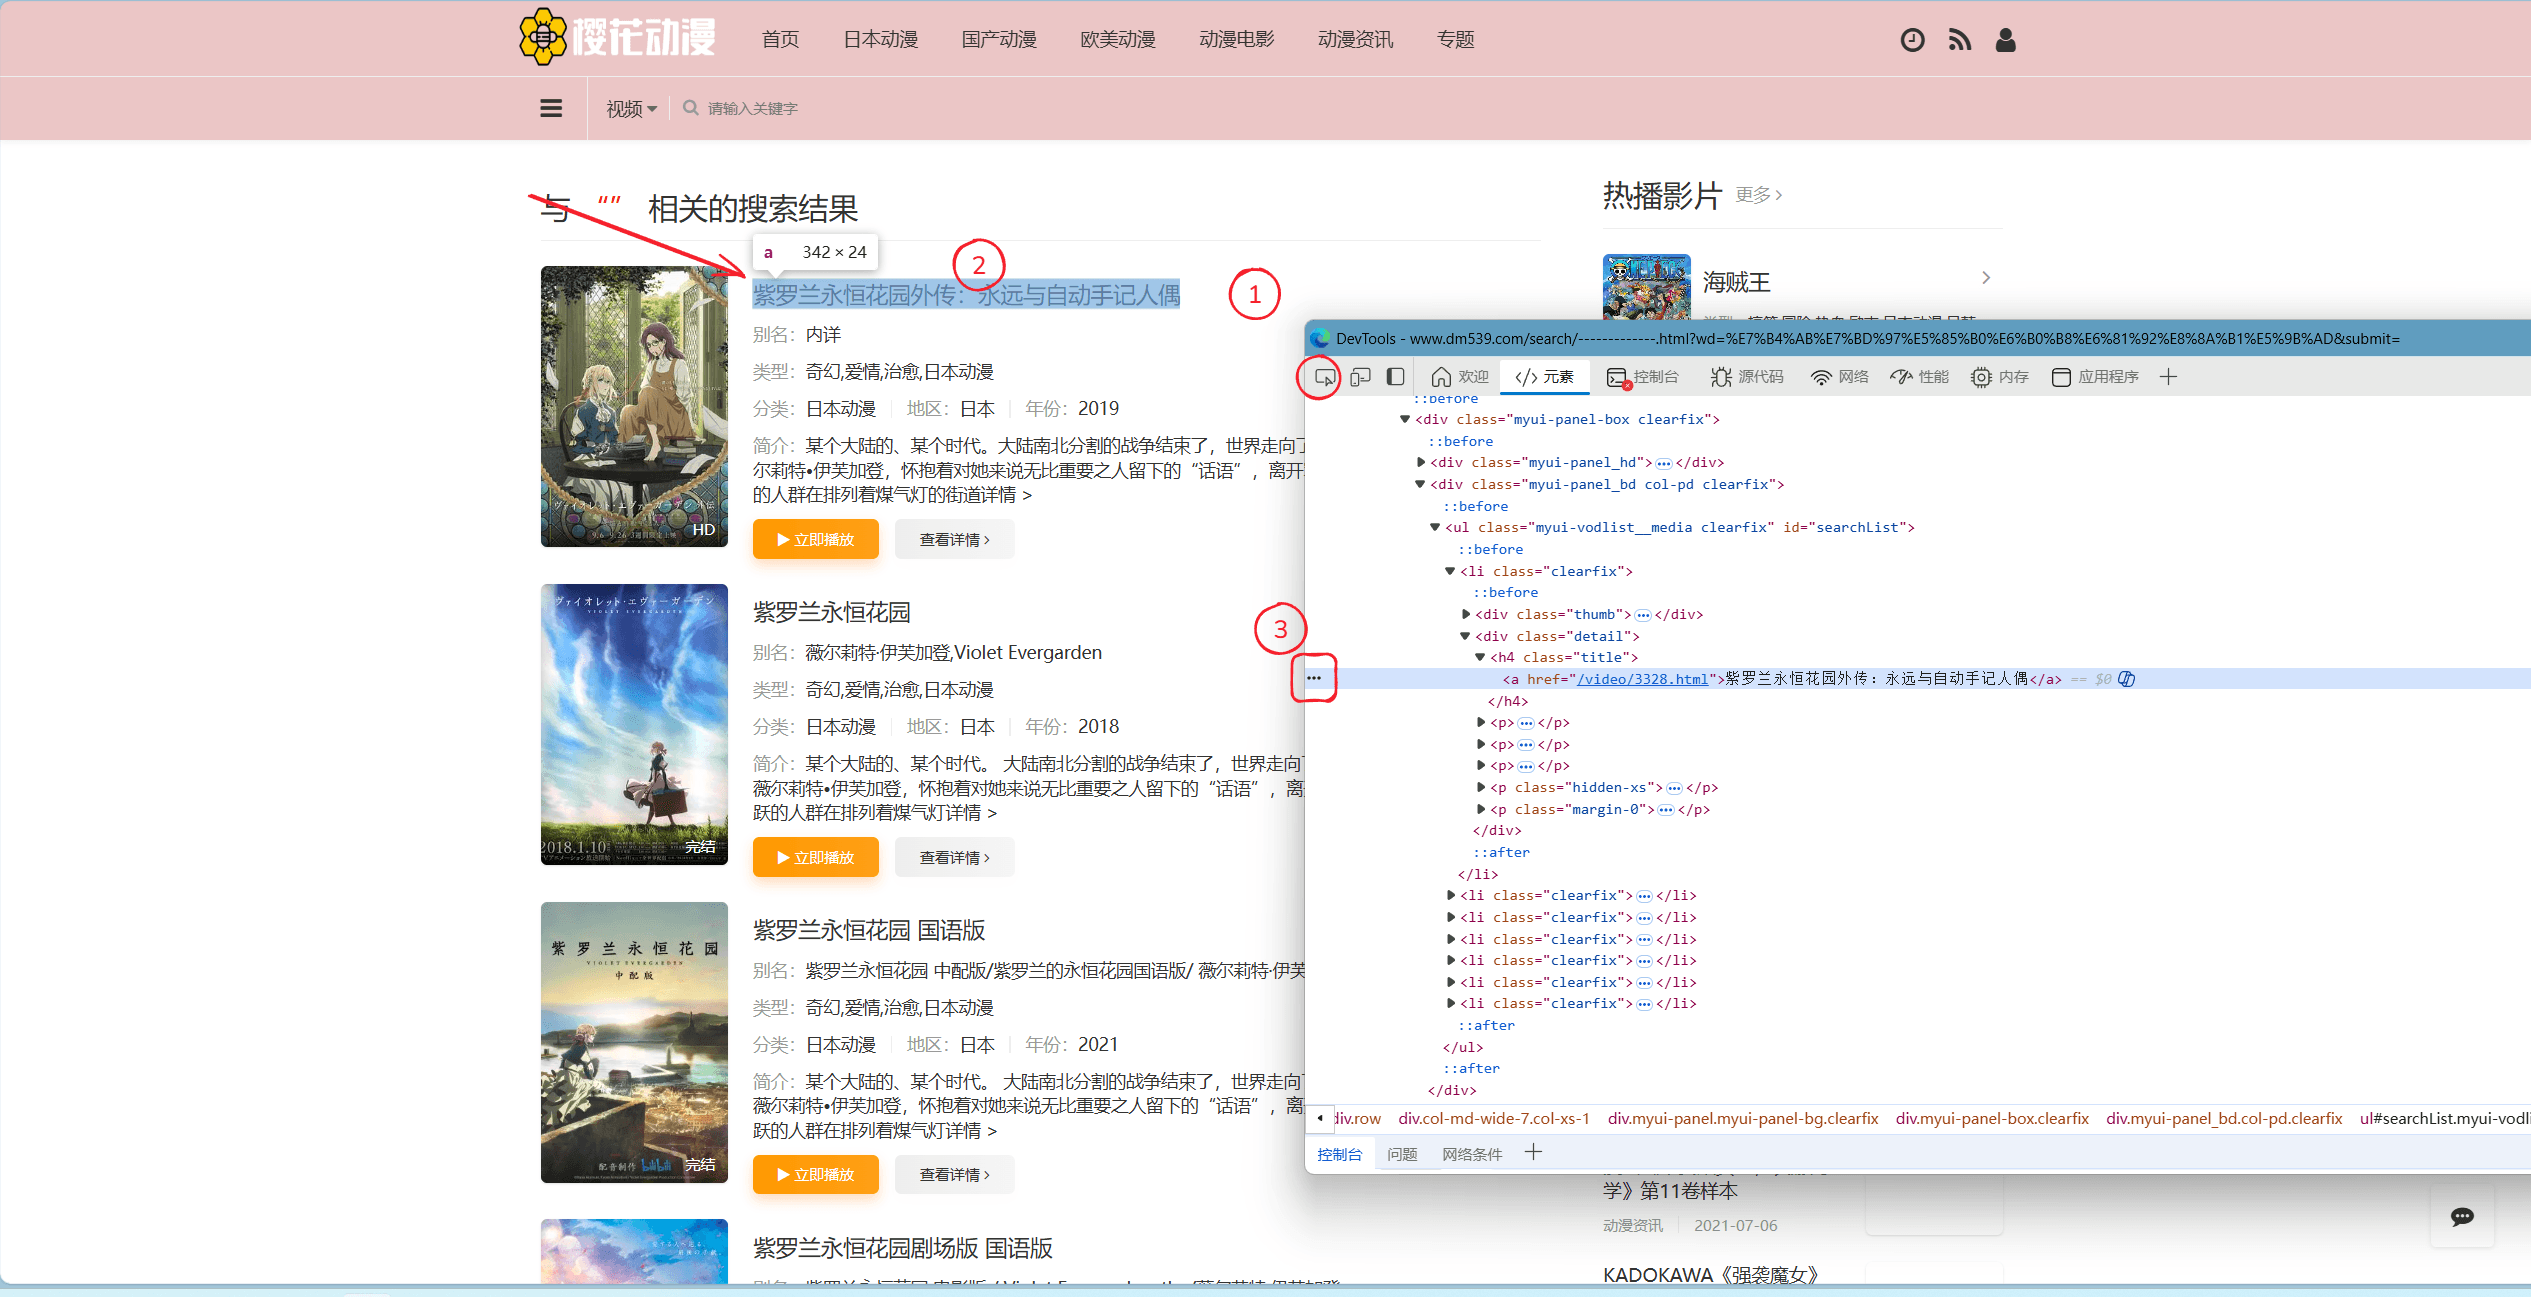
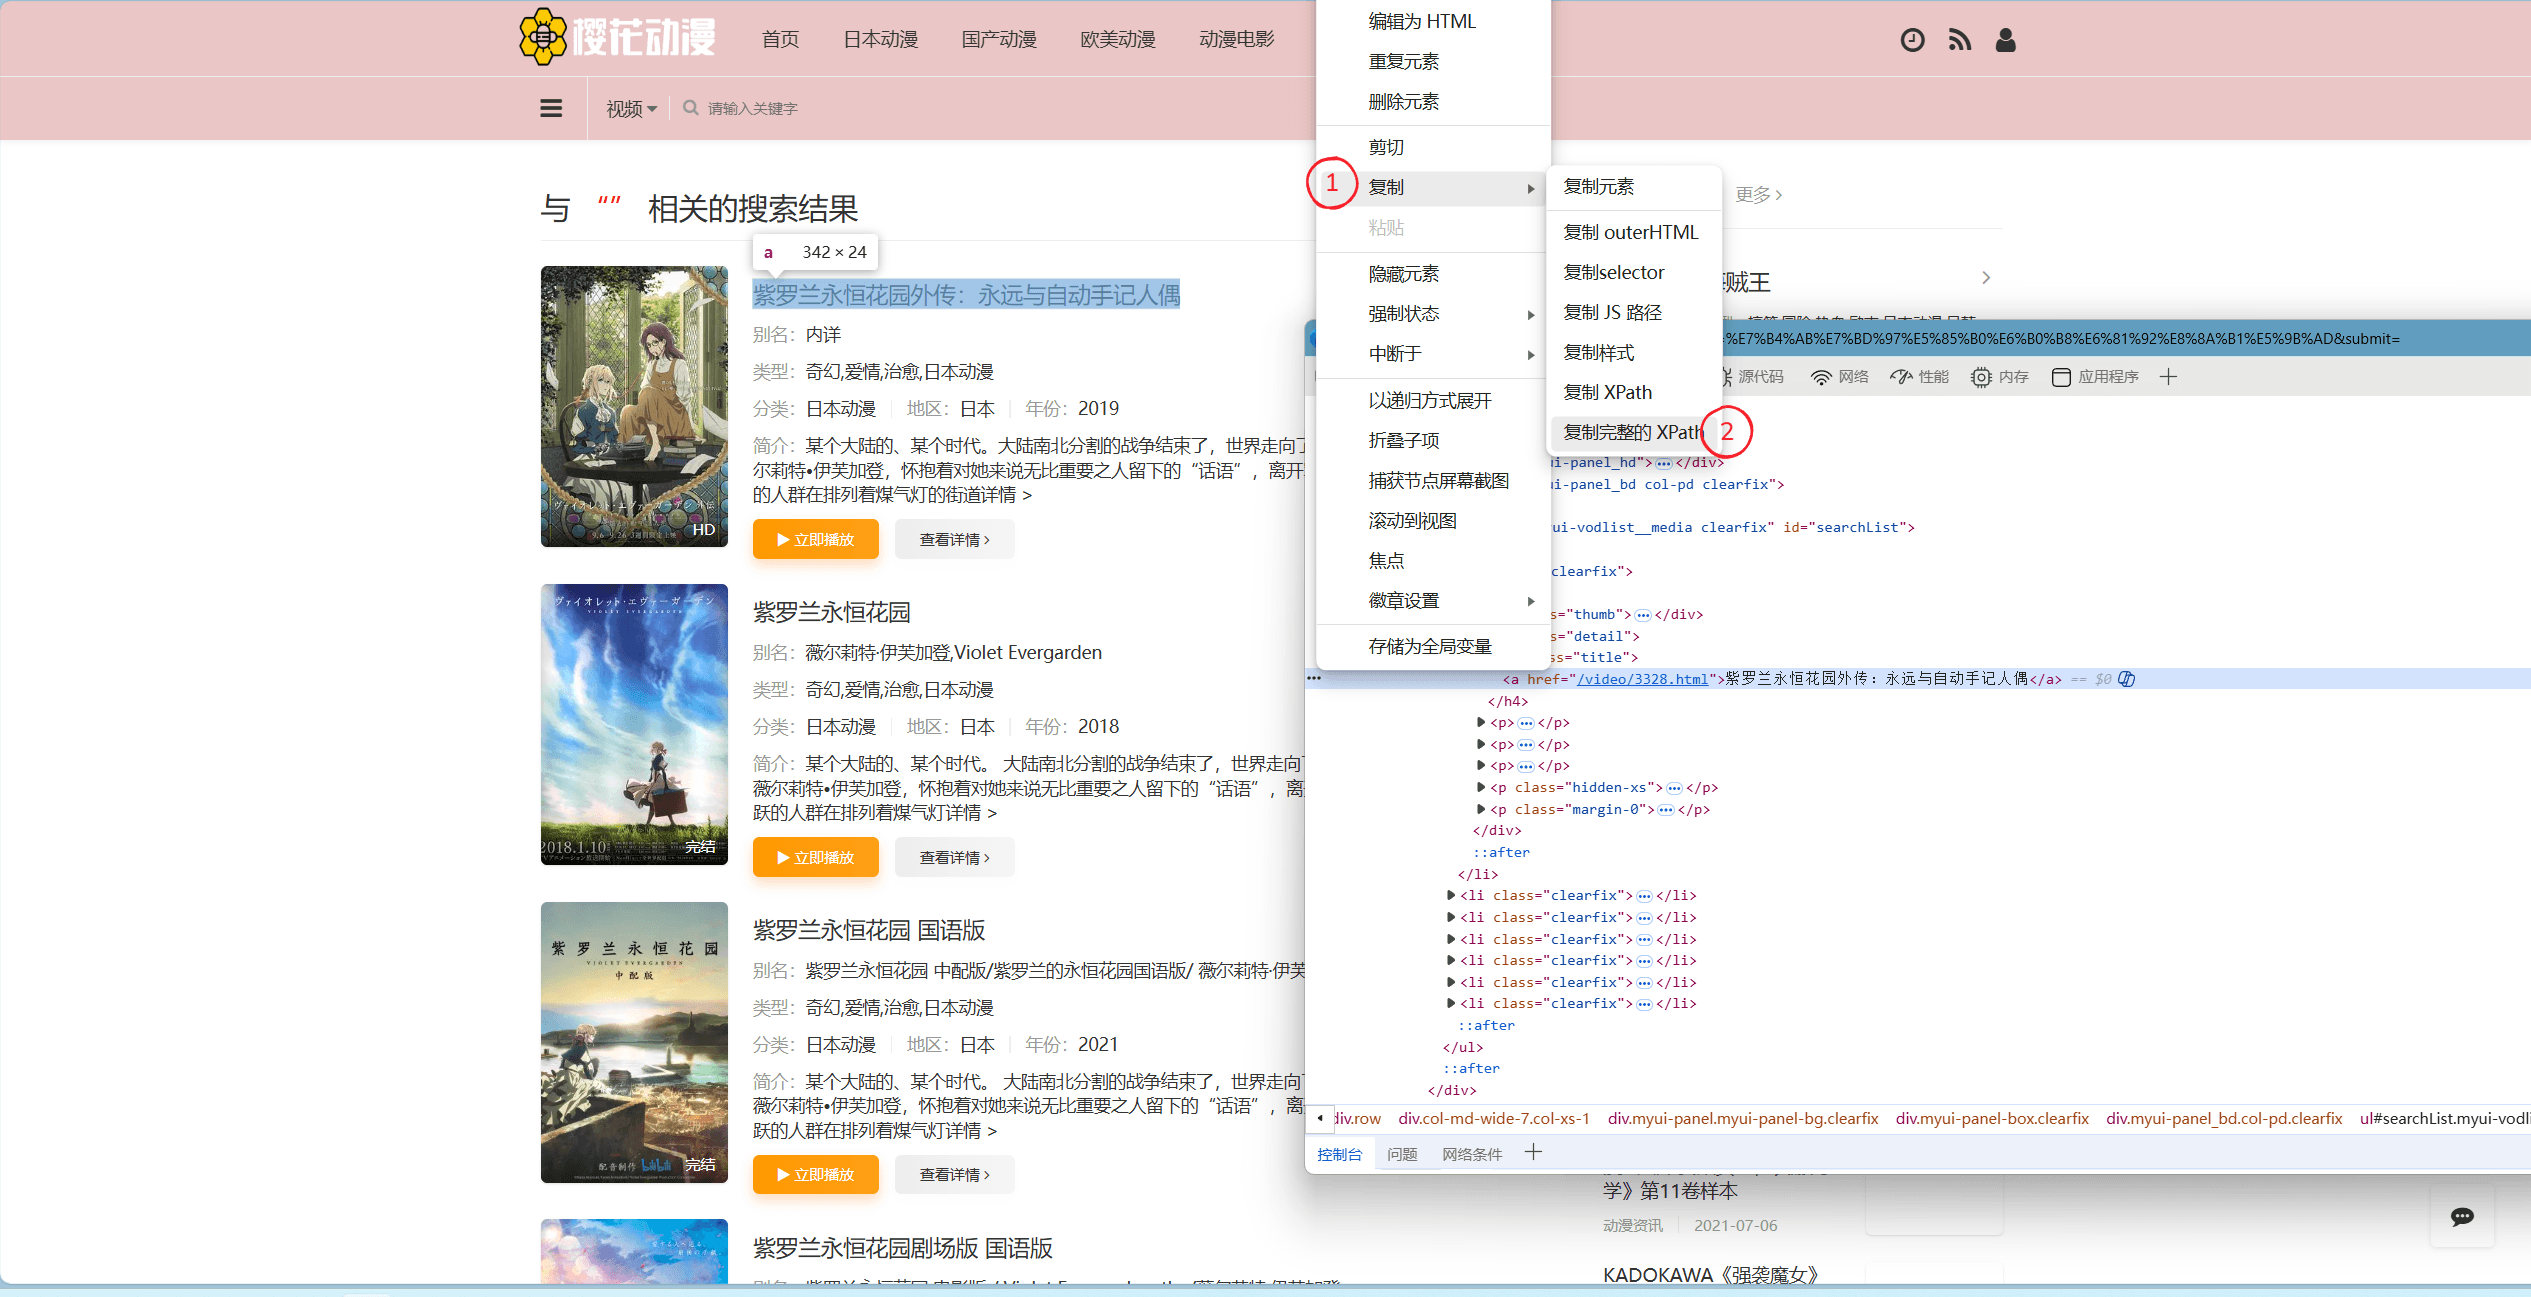
复制结果为:
先按照前文方法移除 /html/body:
将它与 SearchList 对比:
SearchList 已经把解析起点限定为每一个 <li>,因此需要删除到 li[1] 为止的公共路径,只保留条目内部的名称路径:
SearchResult
SearchResult 用于从每个搜索结果中提取下一步访问的页面链接。按照下图定位详情入口,并选择“复制”→“复制完整的 XPath”:
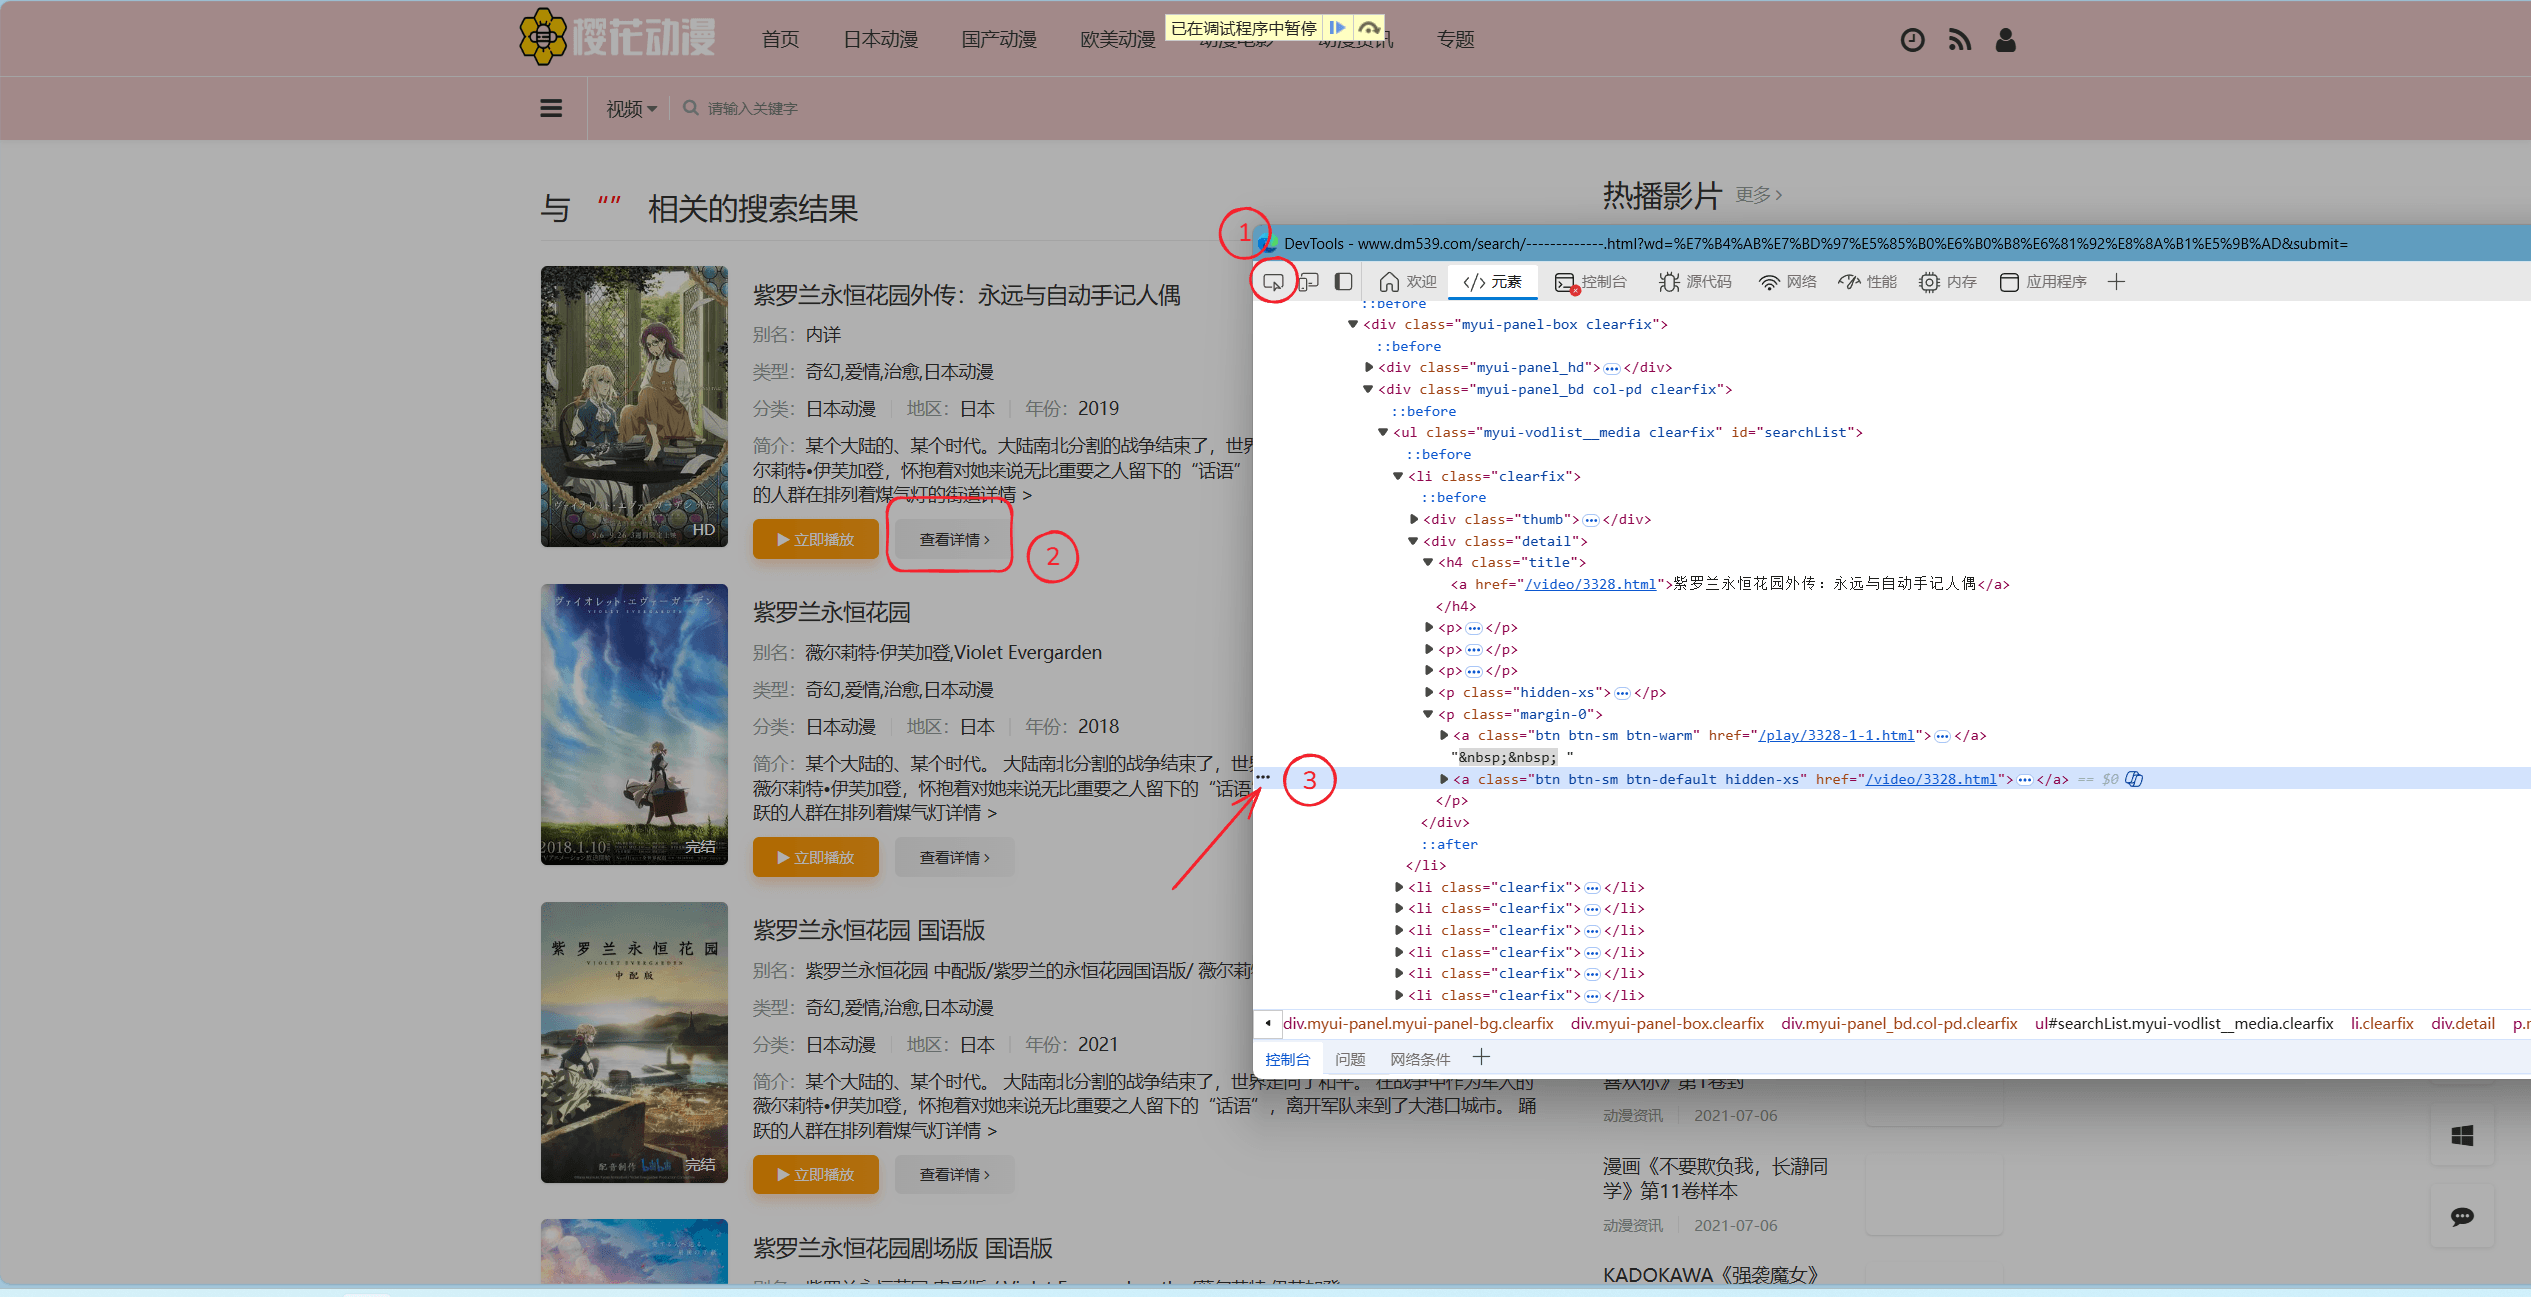
复制结果为:
与 SearchName 相同,删除搜索条目的公共路径,得到:
SearchResult 决定樱花动漫随后访问哪个页面,ChapterRoads 和 ChapterResult 必须按照该页面的 HTML 结构编写。
如果 SearchResult 指向详情页,樱花动漫将在详情页中解析线路和剧集:
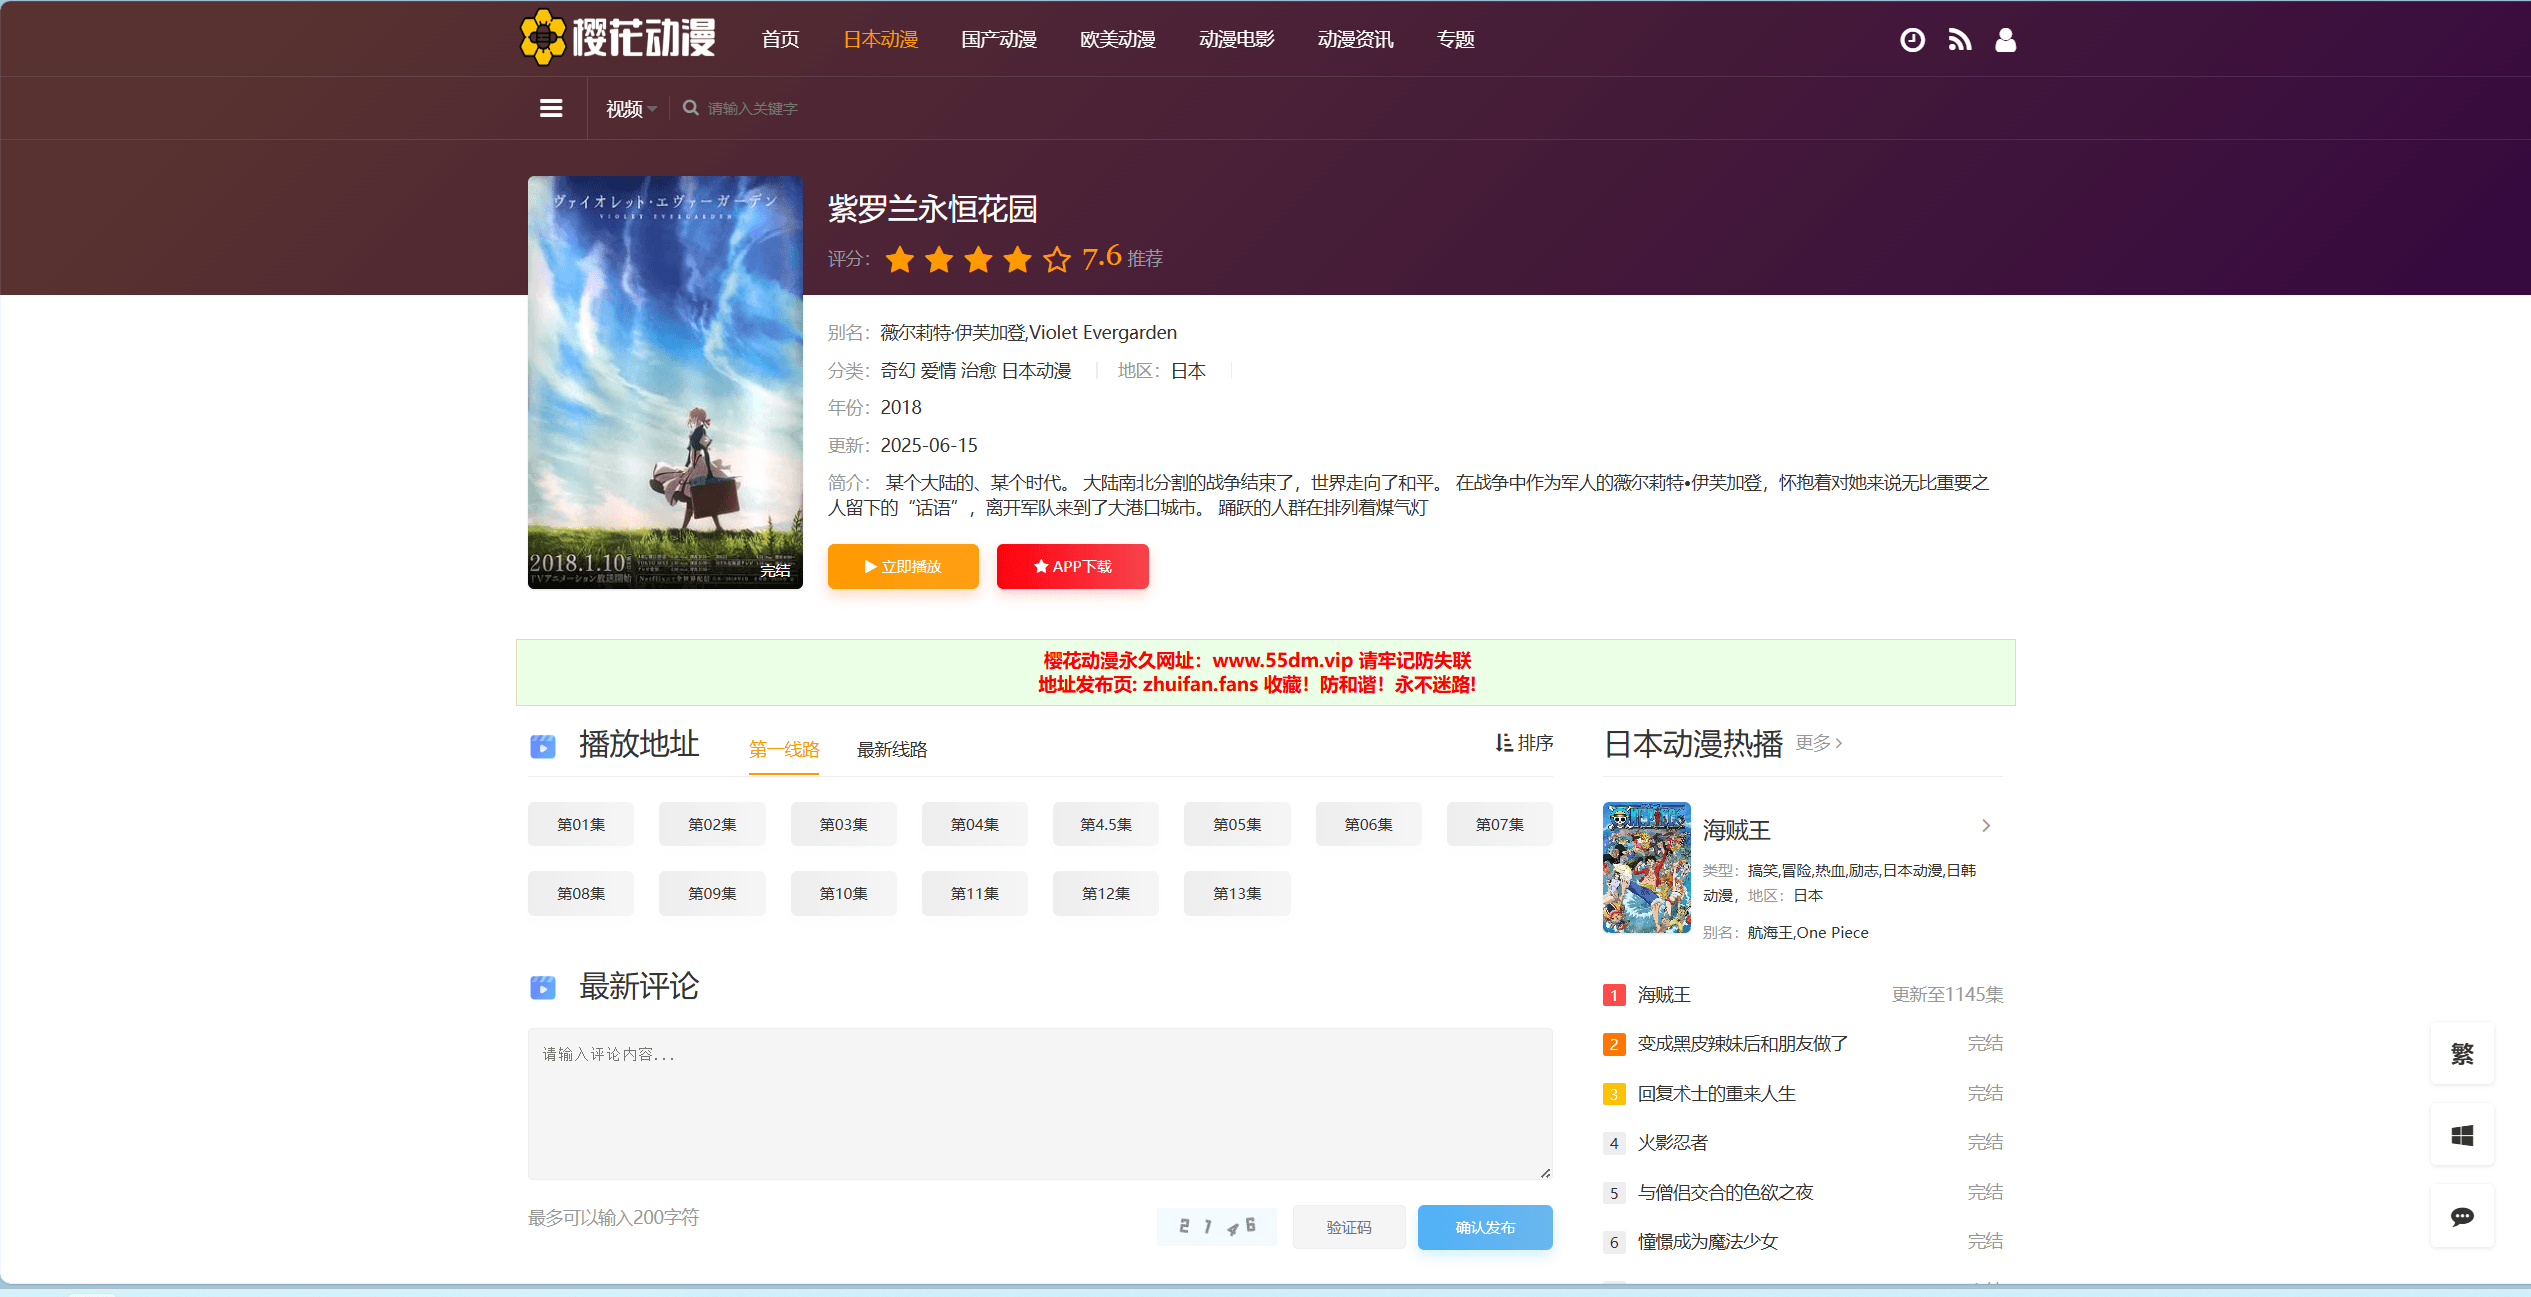
如果它指向“立即播放”入口,樱花动漫将在播放页中解析线路和剧集:
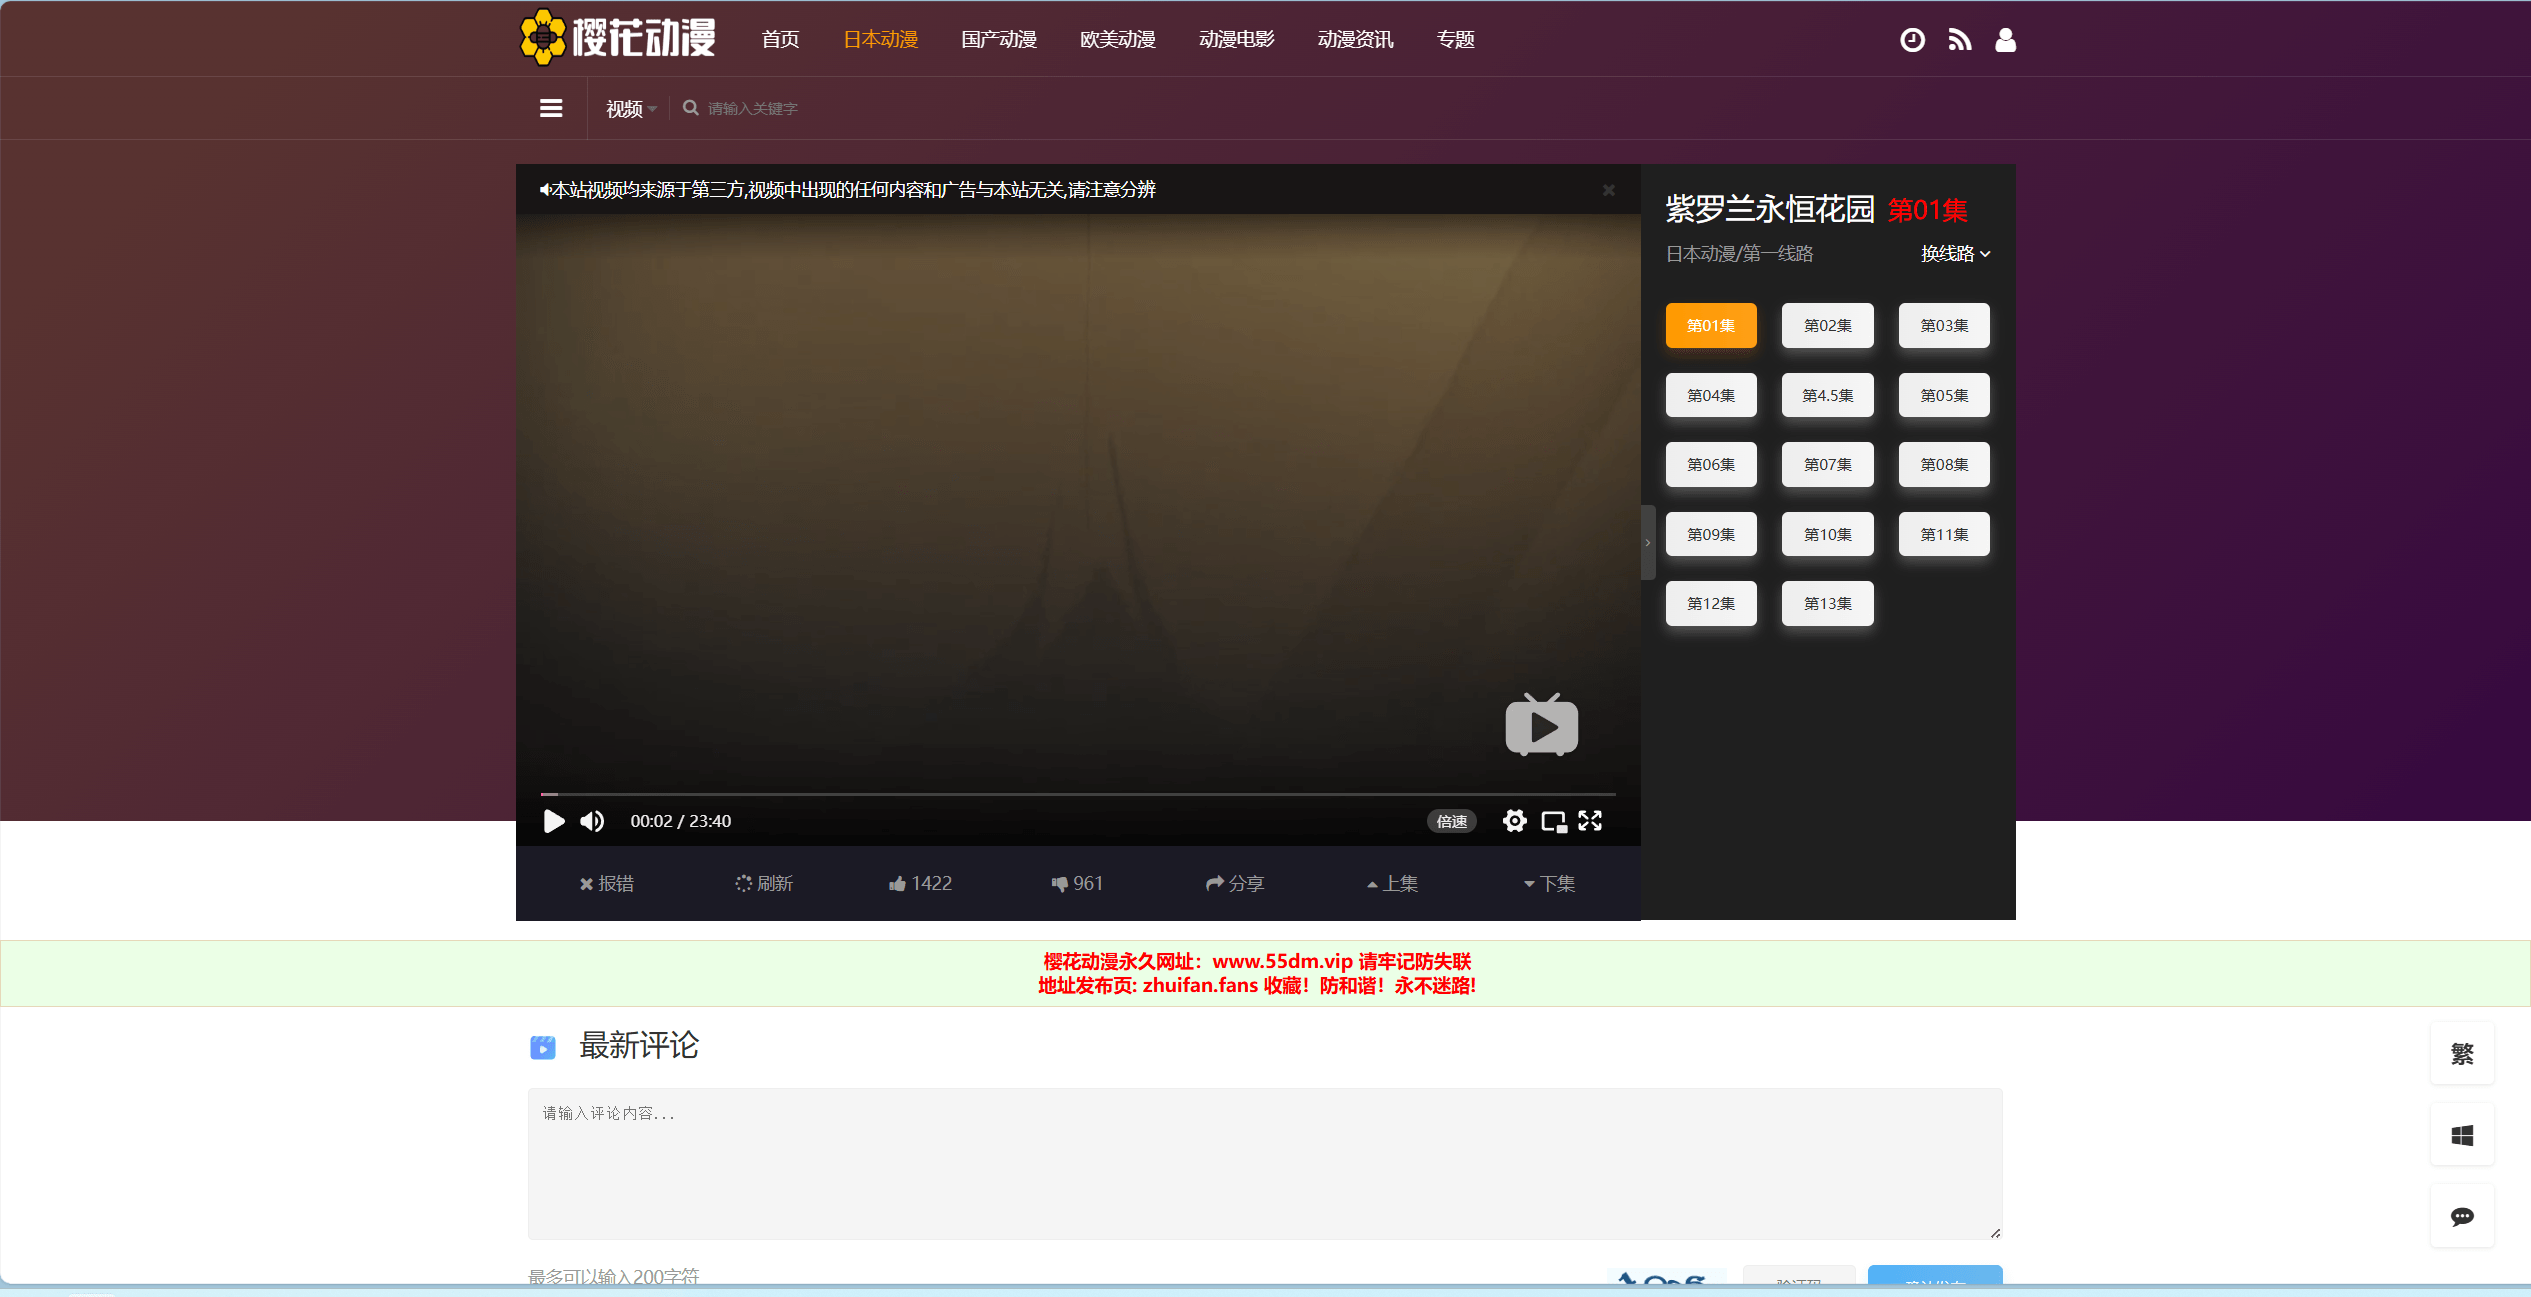
两个页面的 HTML 结构通常不同,不能共用同一组选集 XPath。若搜索结果没有独立的详情按钮,但作品名称可以进入详情页或播放页,可以让 SearchResult 使用与 SearchName 相同的链接元素。
ChapterRoads
ChapterRoads 用于选中目标页面中的每一个播放线路。打开 SearchResult 指向的页面,并按照与 SearchList 相同的方法定位线路区域:
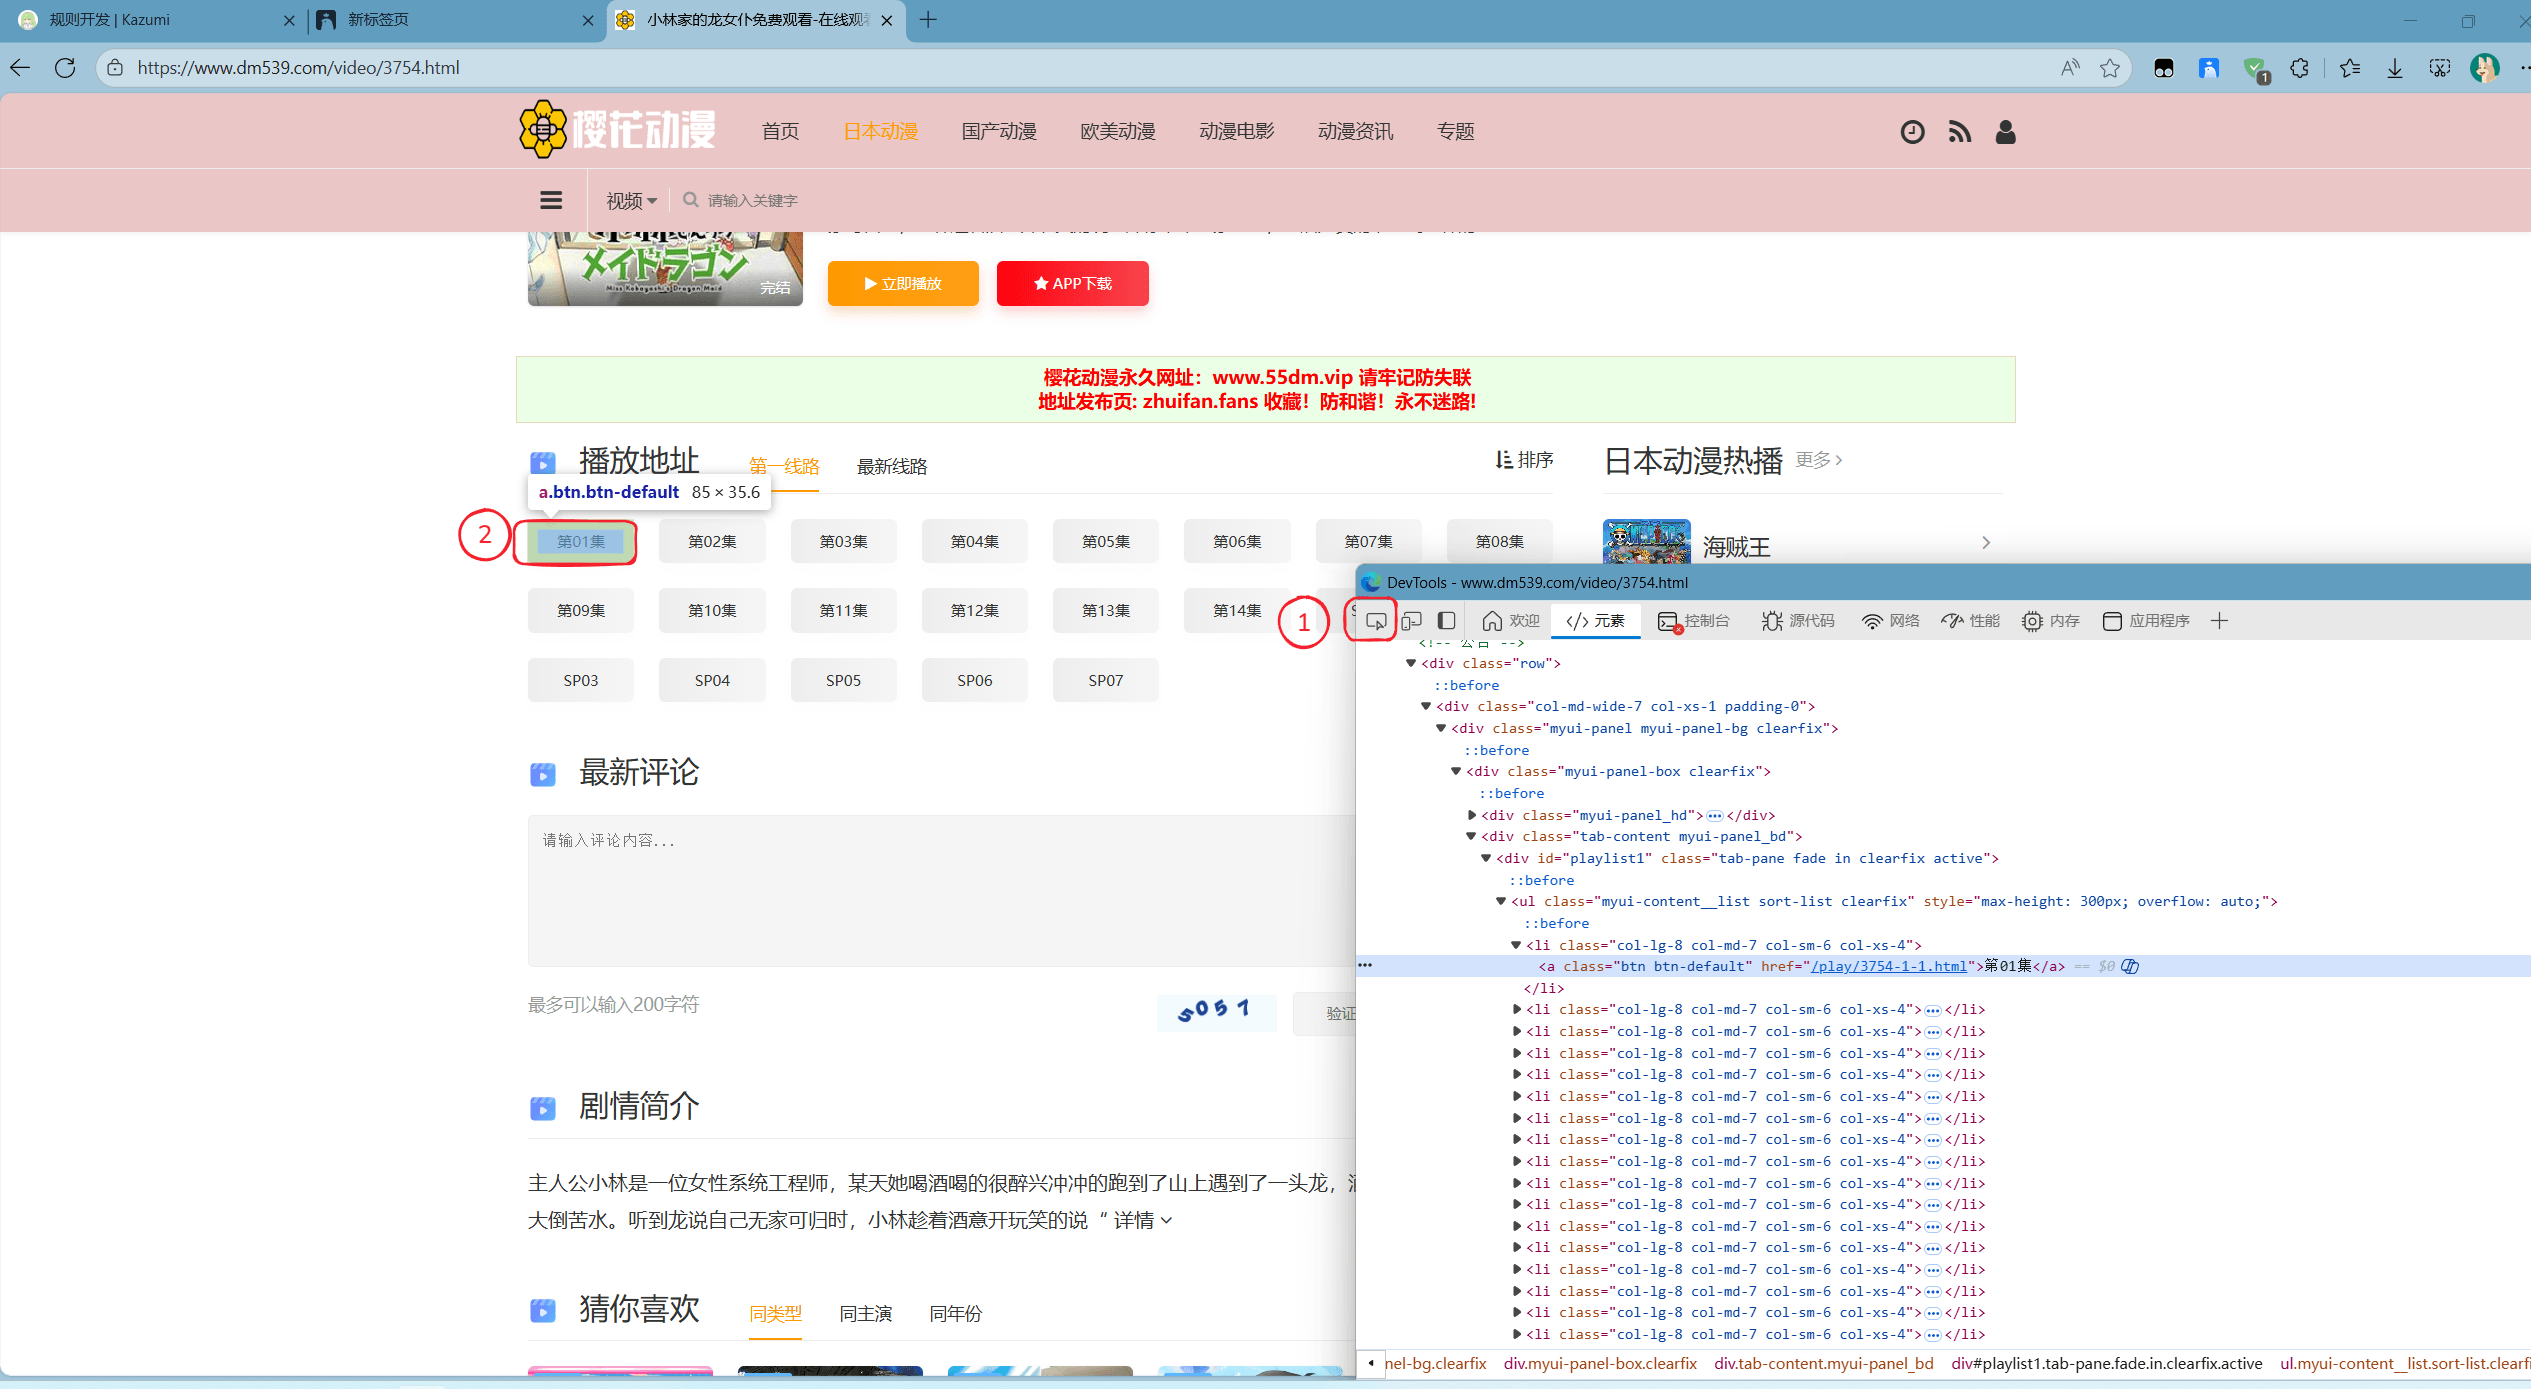
从任意剧集元素逐级向上查找。当高亮区域覆盖一条线路的全部剧集时,折叠对应元素。页面有多少条线路,通常就会出现多少个结构相同的容器:
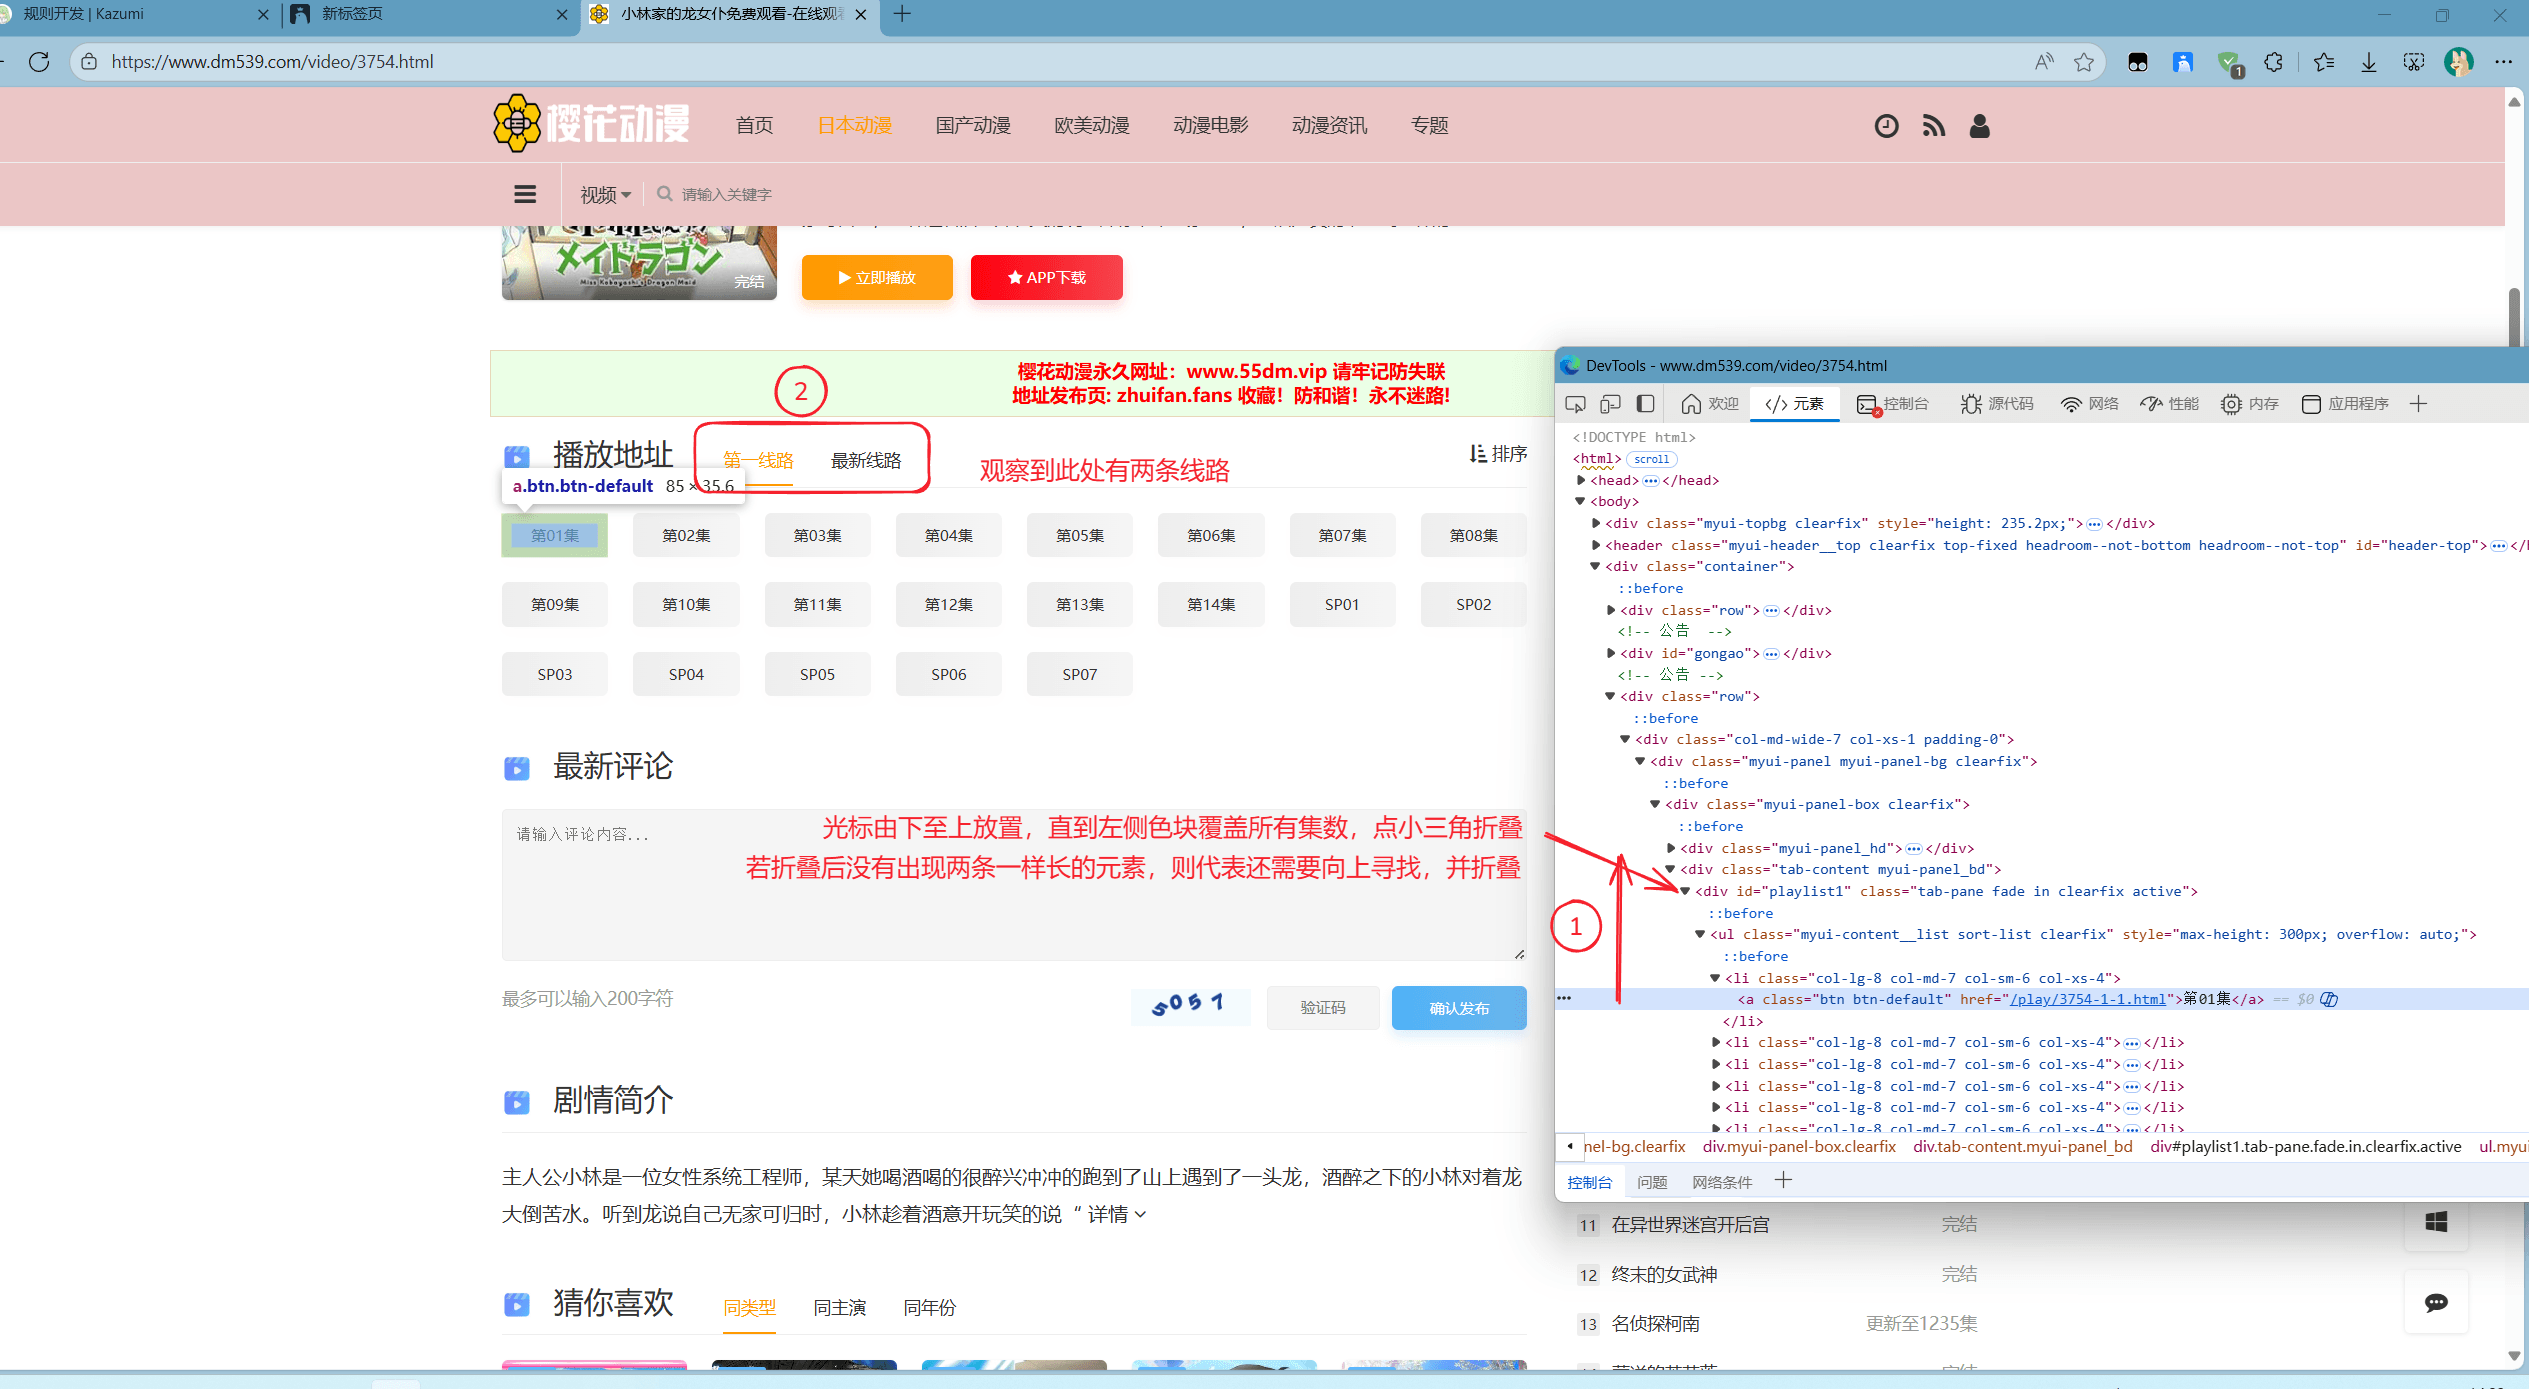
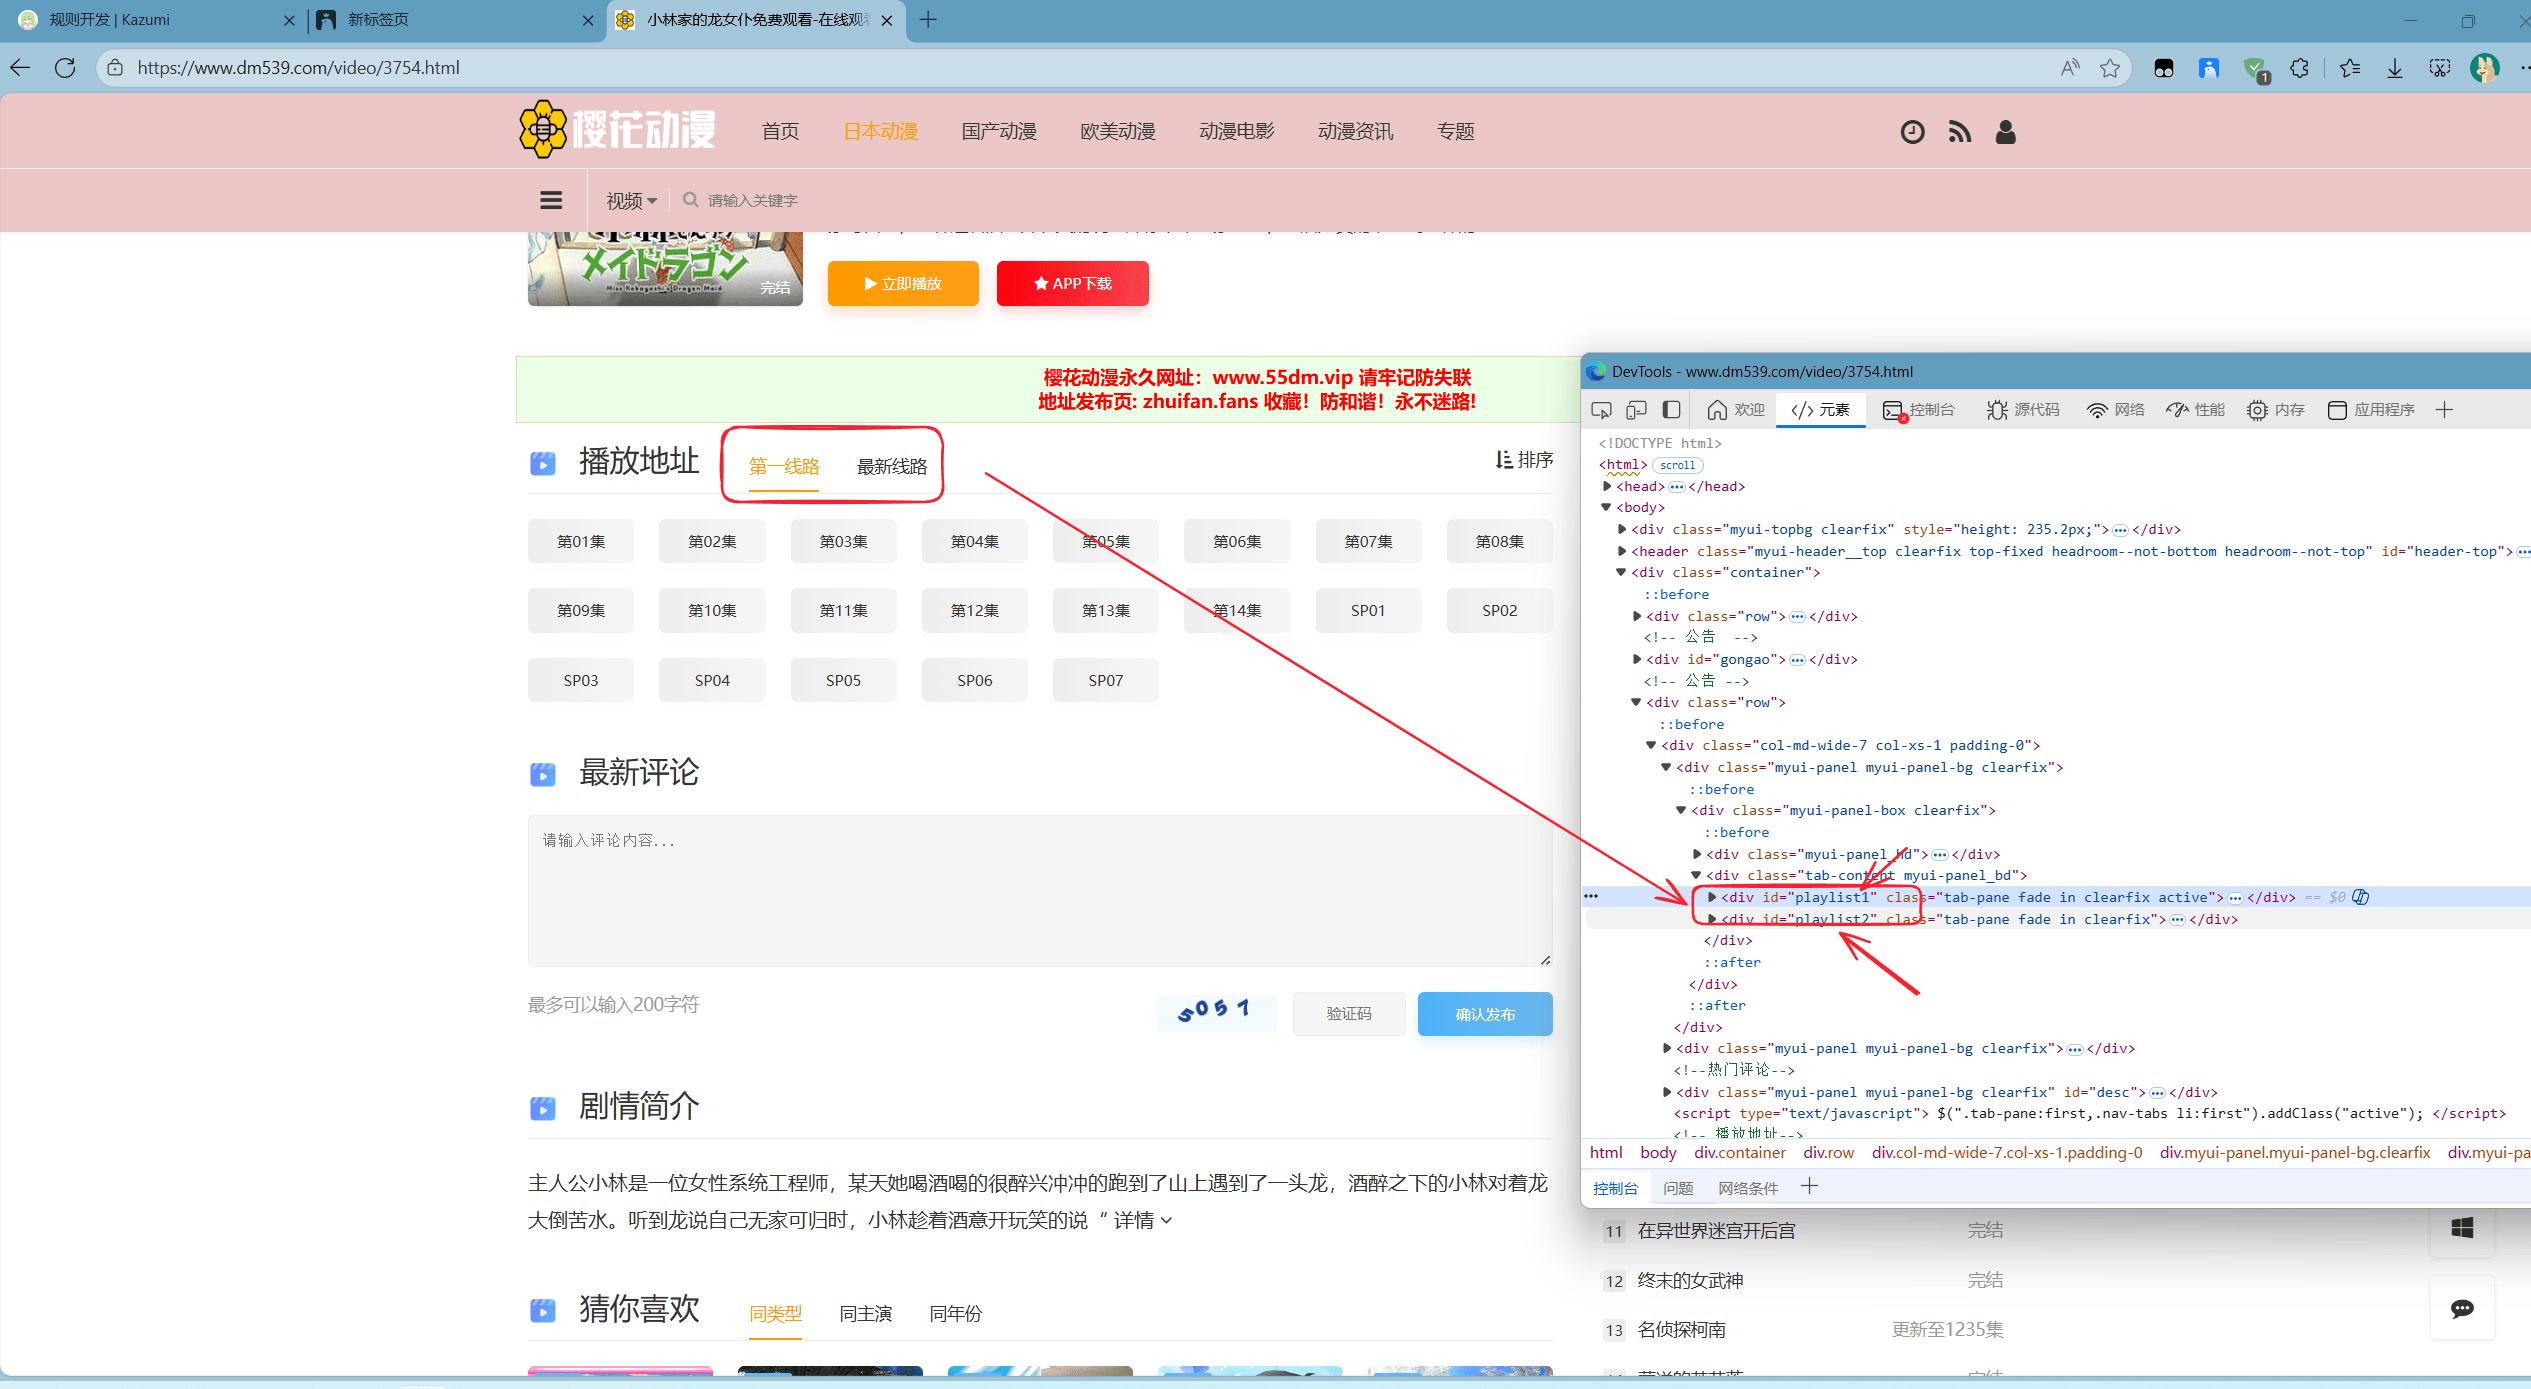
选择所有线路容器的公共父元素,并复制完整 XPath:
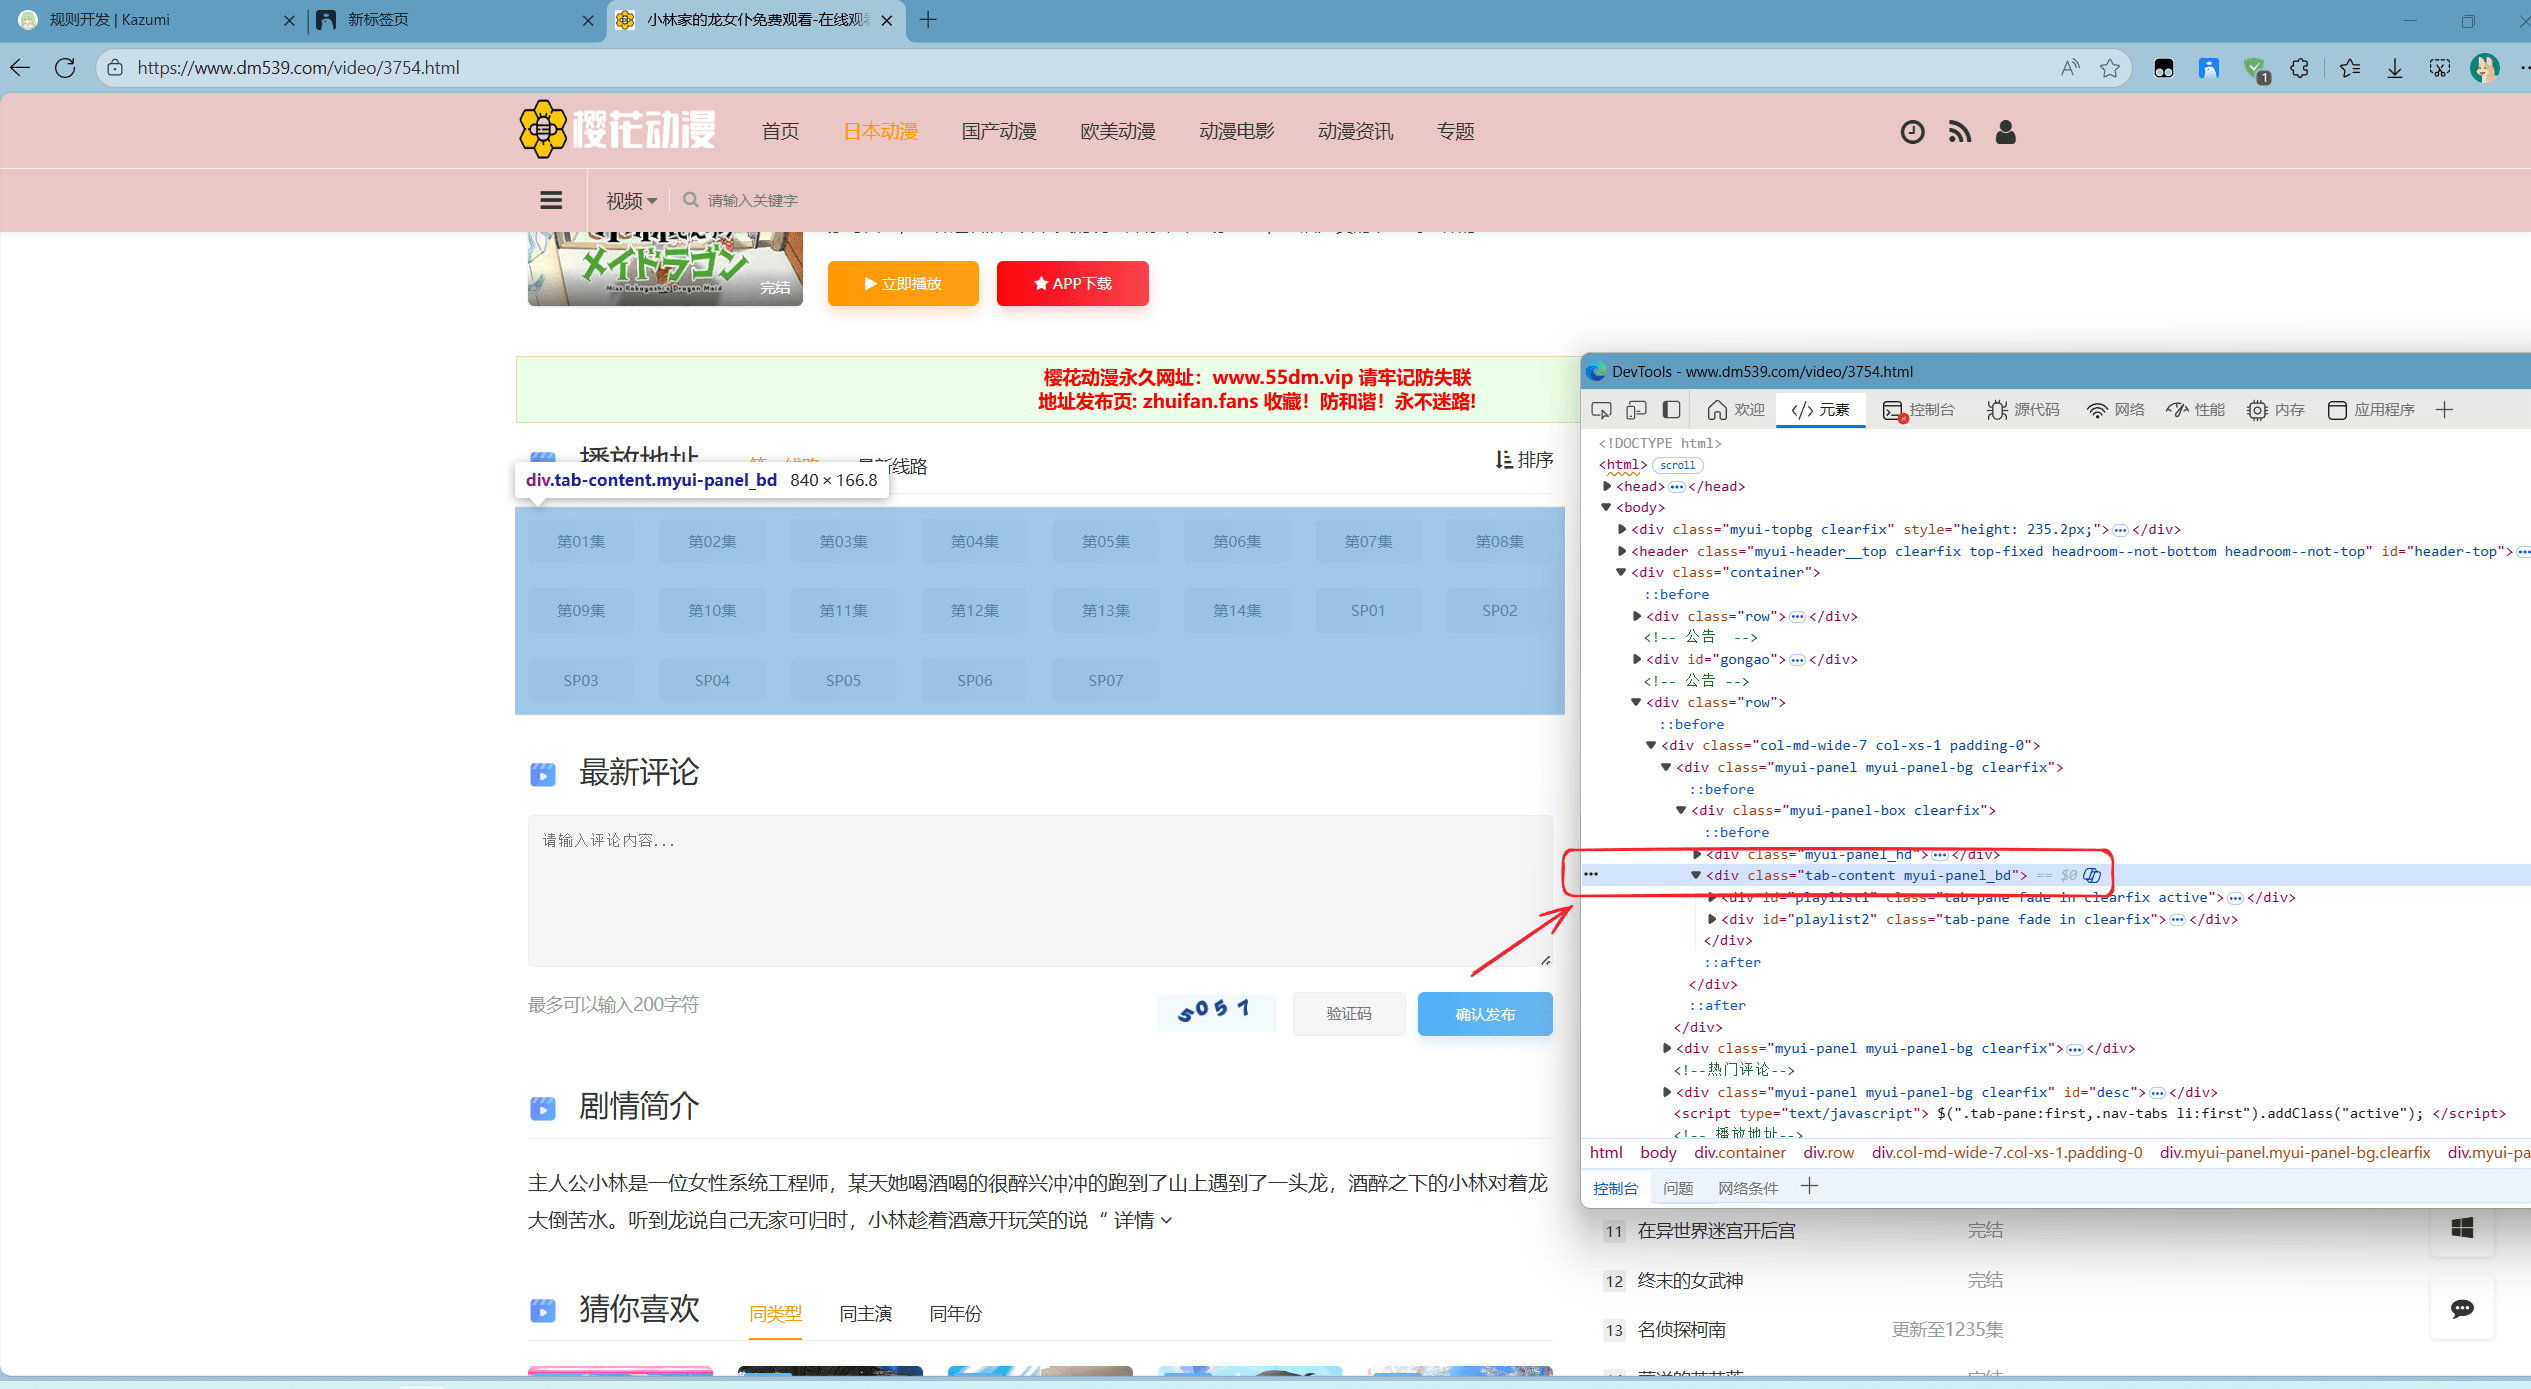
复制结果为:
移除 /html/body 后得到:
该表达式定位到线路列表的父容器。每一条线路是其下级 <div>,因此追加 //div:
ChapterResult
ChapterResult 用于从每条线路中选中全部剧集链接。使用元素选择器定位任意一集,并复制完整 XPath:
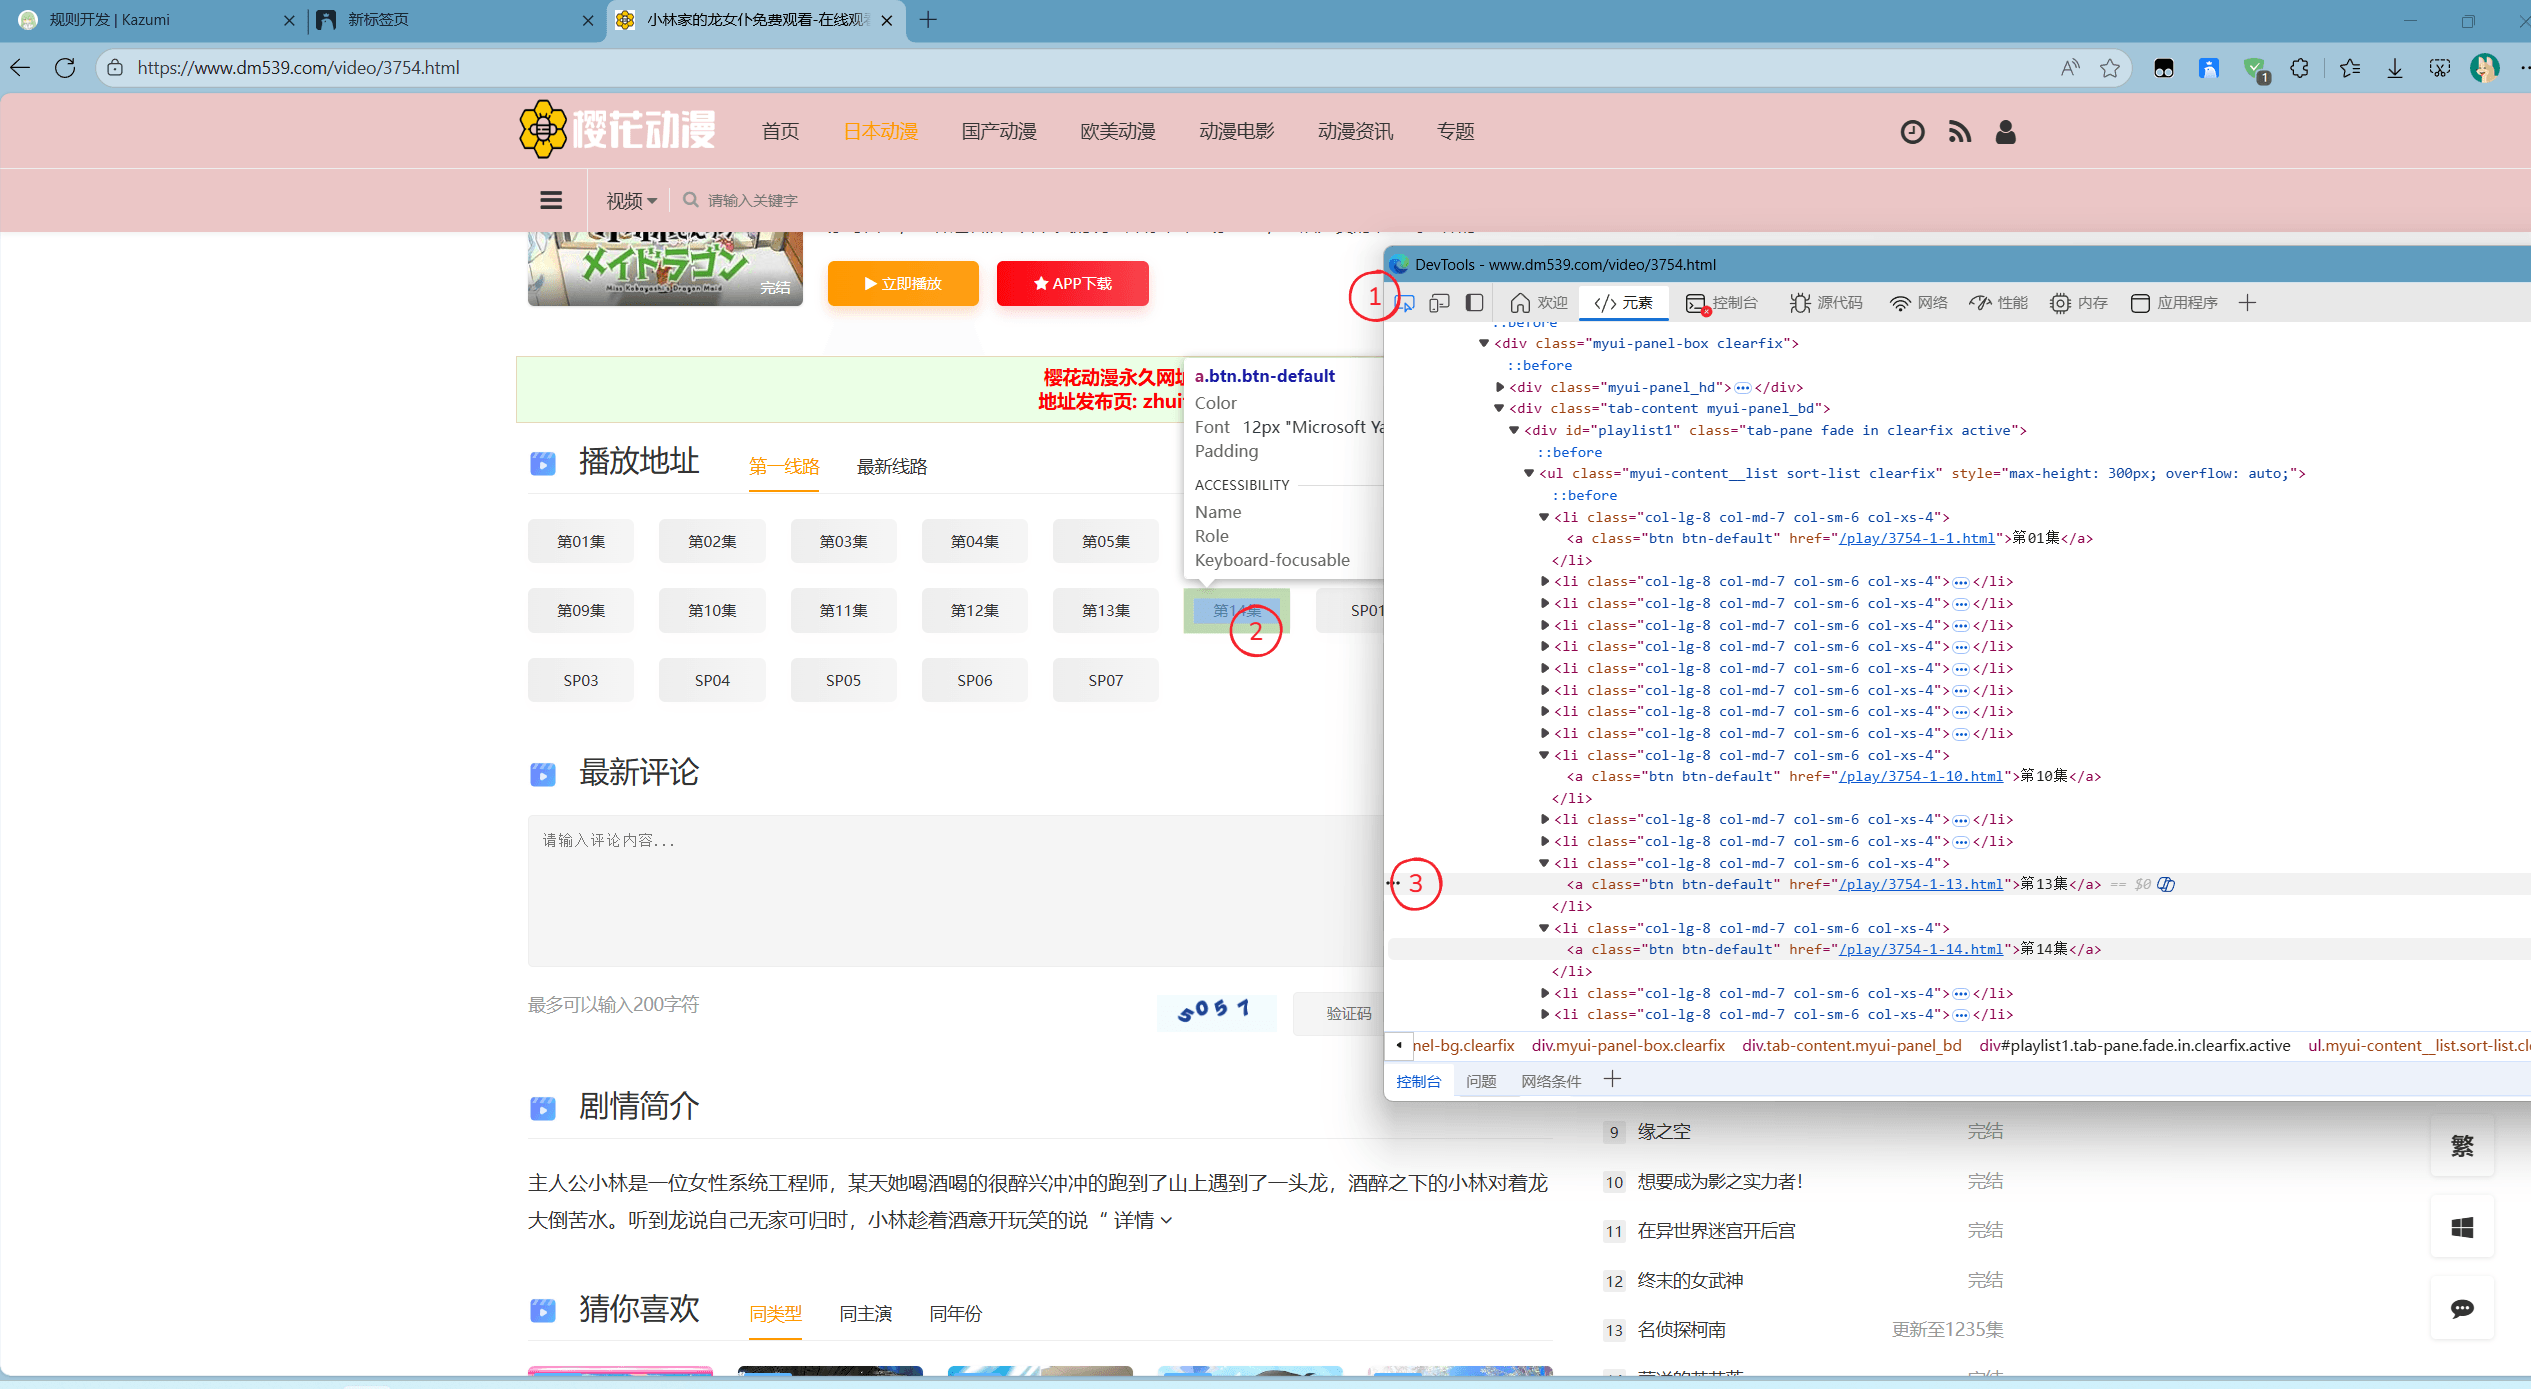
以下示例定位到第 12 集:
删除 ChapterRoads 已经覆盖的公共路径后得到:
li[12] 只会选中第 12 个元素。规则需要返回全部剧集,因此删除位置限制 [12]:
至此,搜索、详情入口、播放线路和剧集链接均已配置完成。保存前应使用规则测试功能检查搜索结果数量、线路数量和剧集顺序。
常见问题
高级选项
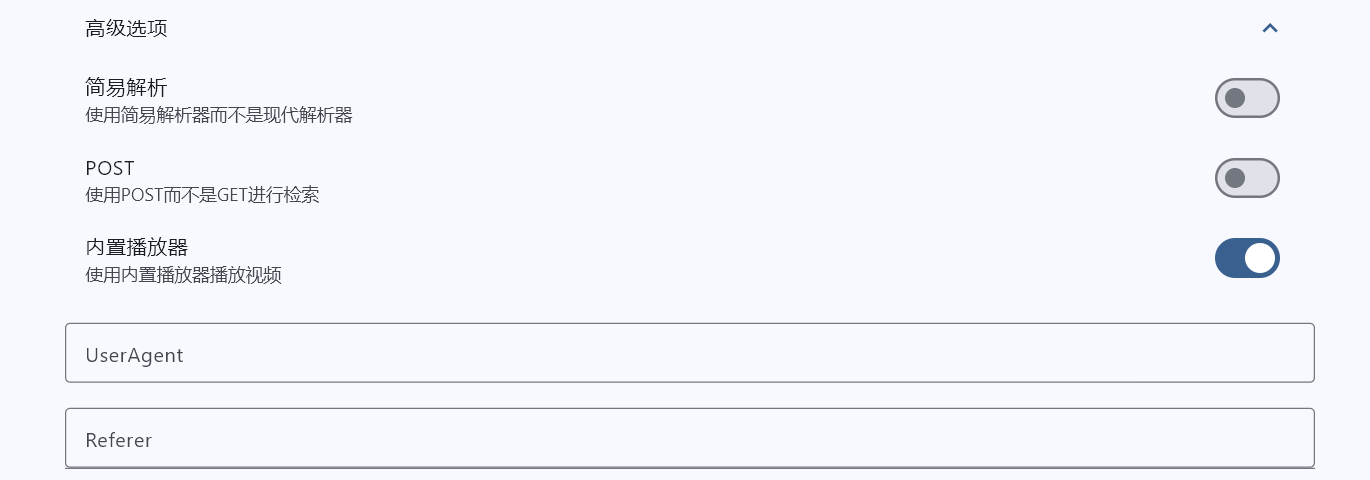
- 简易解析:使用兼容性解析器代替现代解析器。默认保持关闭;仅在现代解析器无法从播放页获取资源时尝试启用。
- 广告过滤:对 HLS 播放列表启用广告片段过滤。仅在确认来源包含可识别的 HLS 广告时启用。
- User-Agent:覆盖播放器和下载器请求中的浏览器身份标识。一般留空;只有来源校验特定 User-Agent 时才需要填写。
- Referer:覆盖播放器和下载器请求中的来源页面。若媒体服务器校验来源,可以填写规则的基础地址或实际要求的页面地址。
- 反反爬虫:用于 XPath 搜索响应被验证页替代的情况。应根据网站实际验证方式配置检测条件和交互步骤。
POST 搜索
部分网站通过 POST 表单提交关键词,搜索完成后地址栏不会包含完整参数。以下以 https://www.mengdao.tv/ 为例。
先在网站中执行一次搜索:
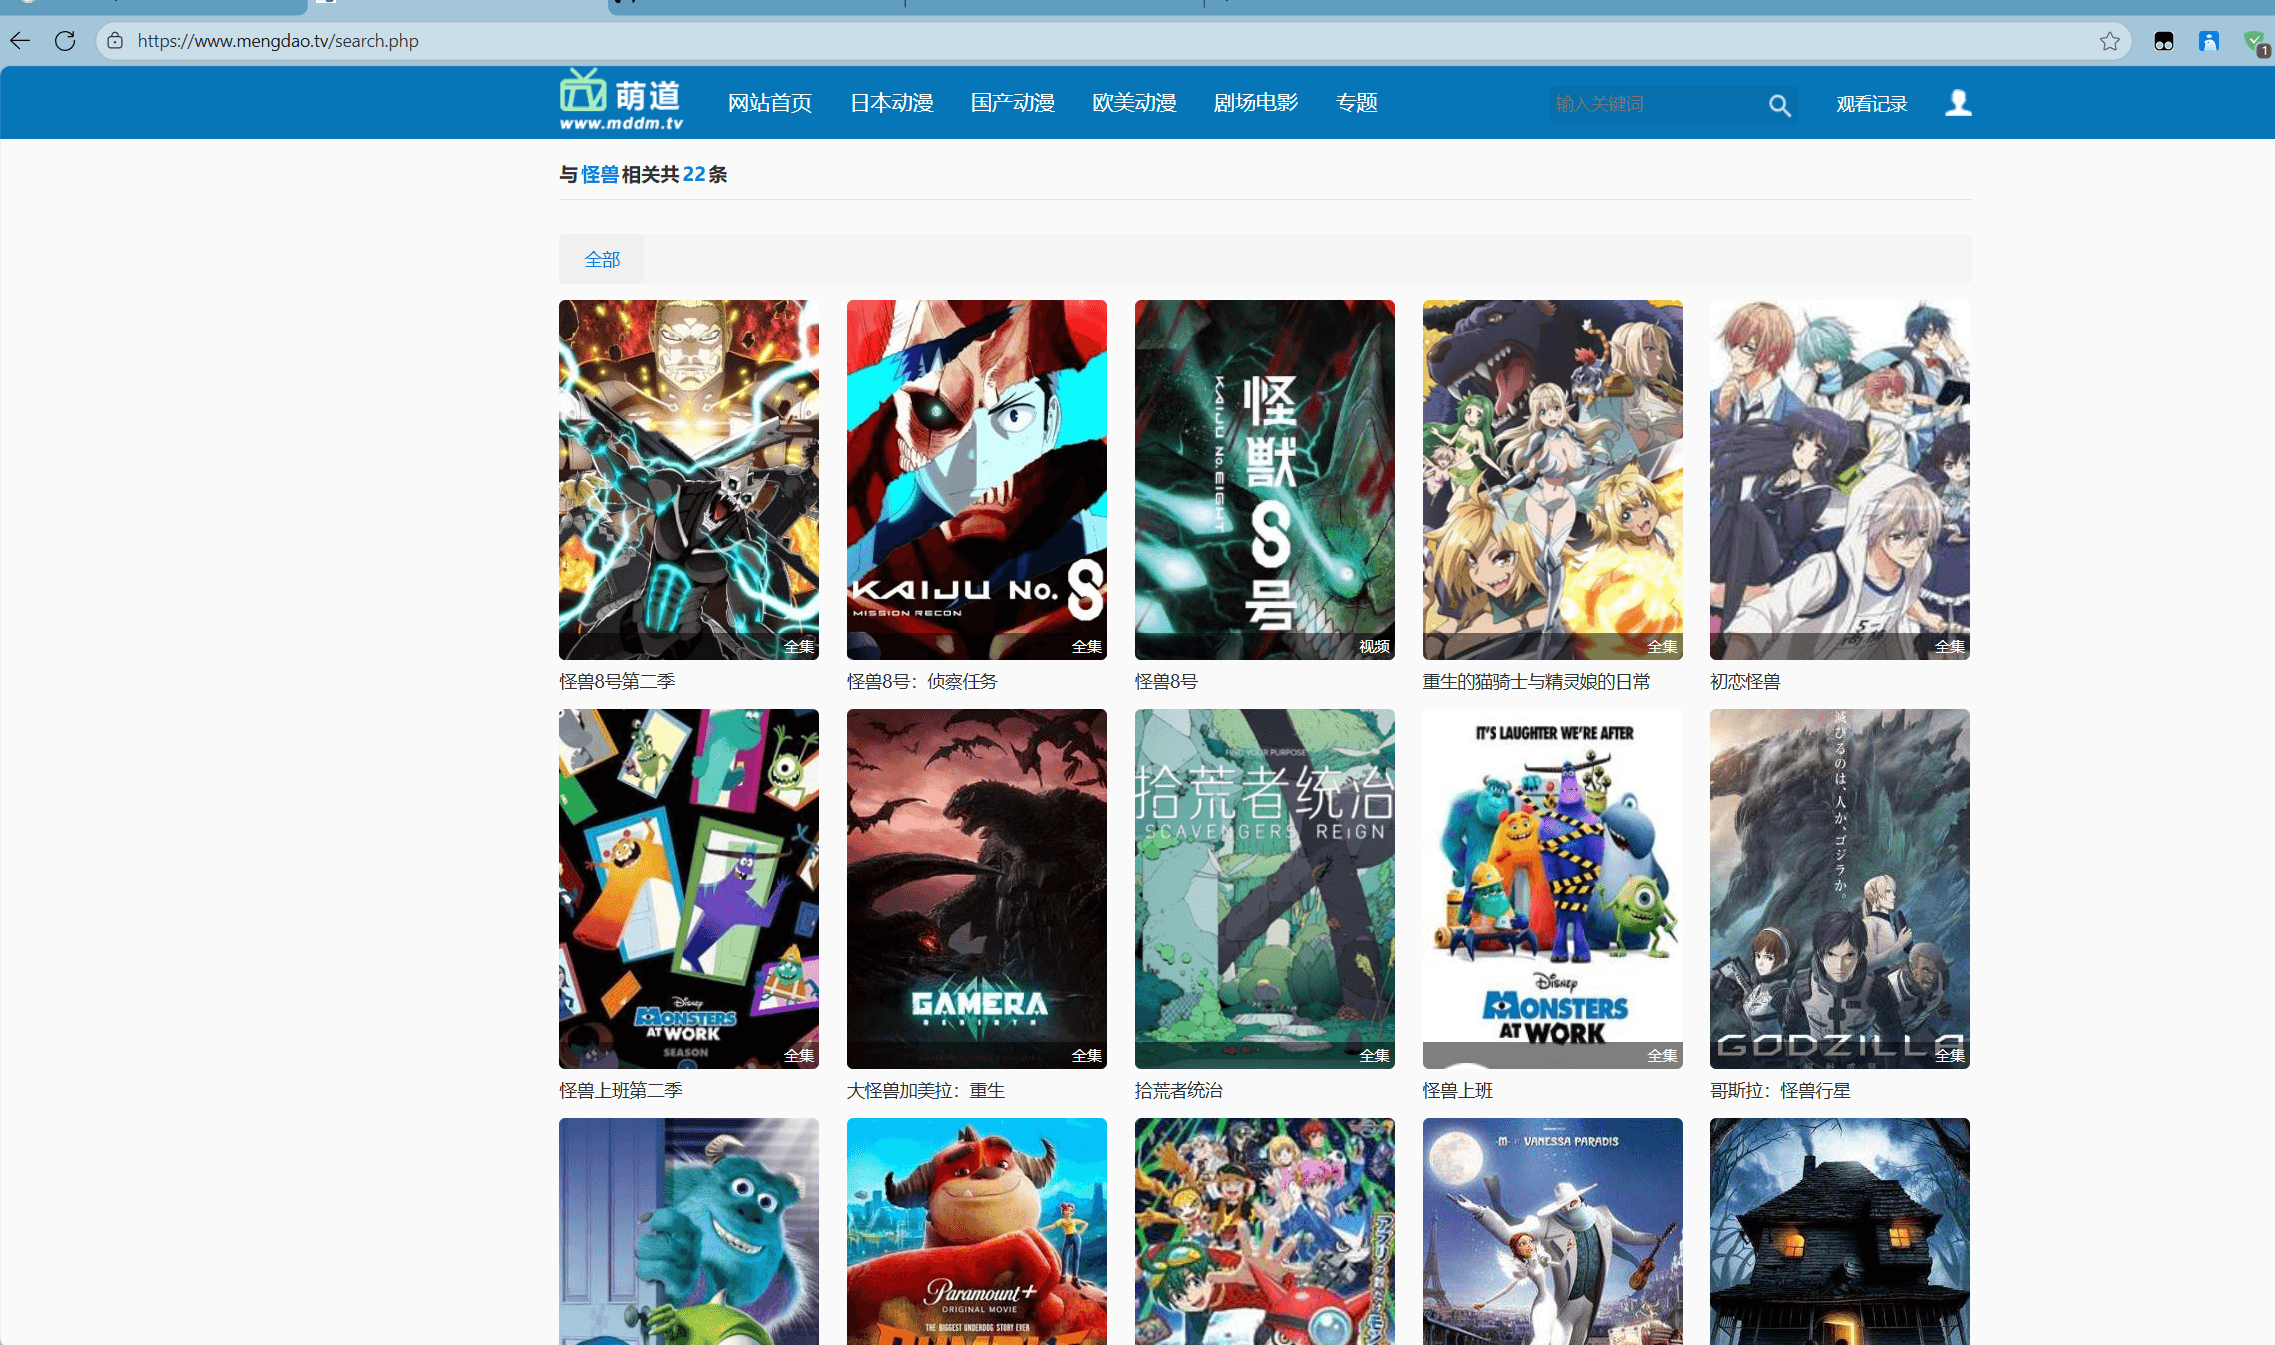
打开开发者工具的“网络”面板并重新执行搜索或刷新页面:
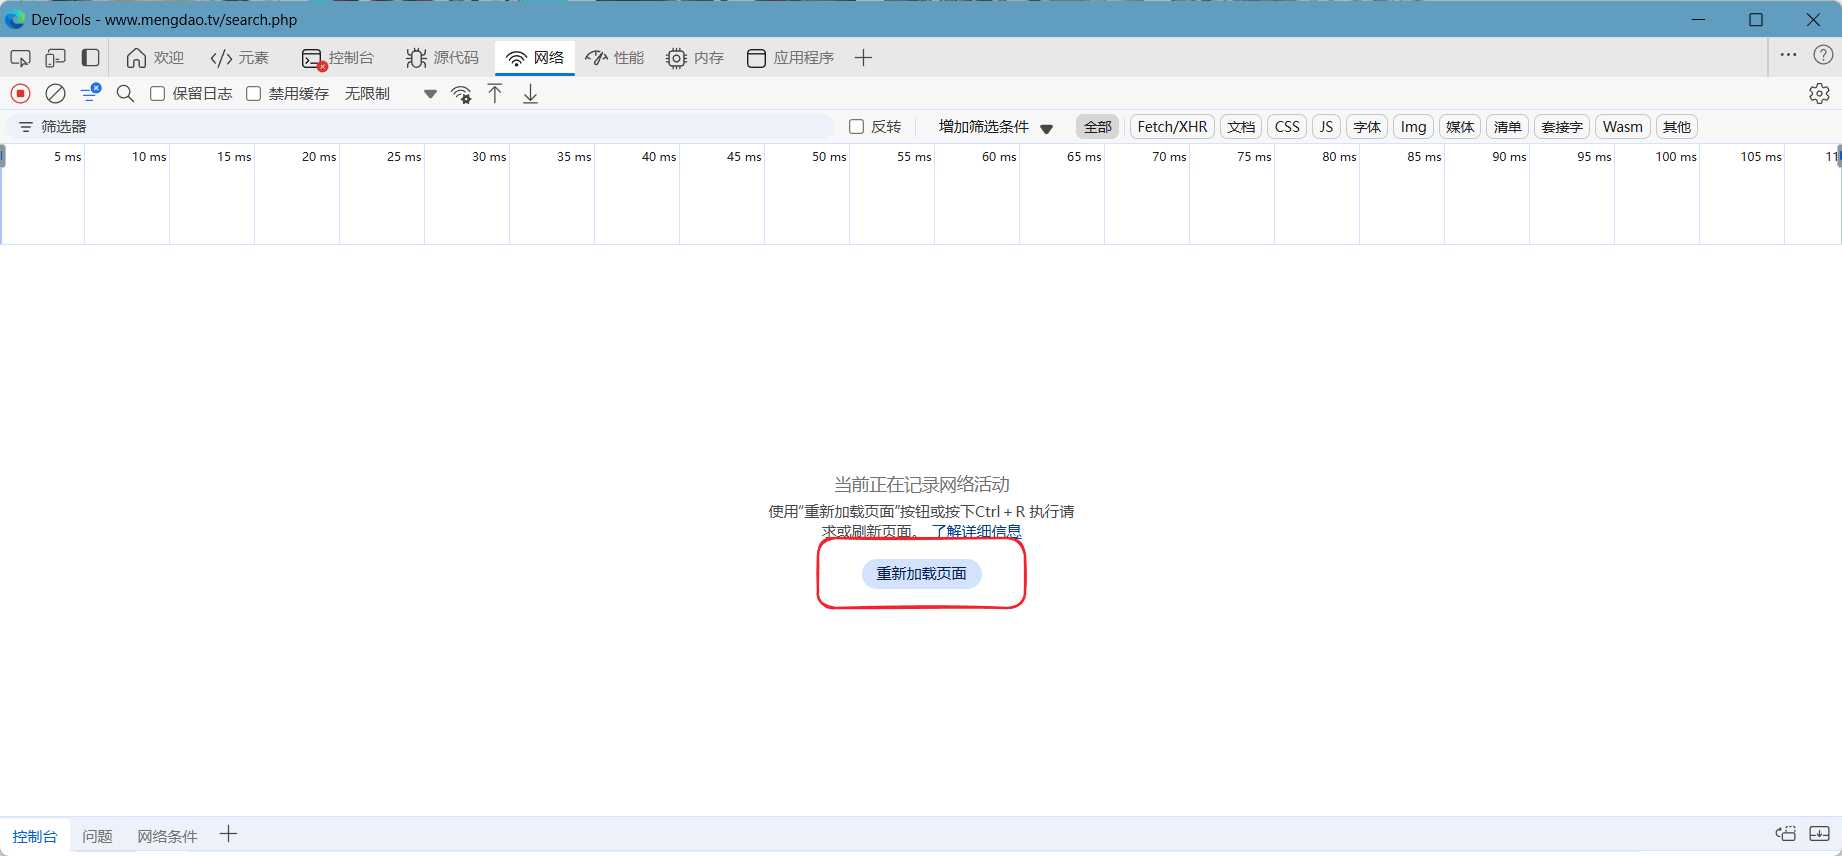
选择负责搜索的 search.php 请求,在“负载”或“Payload”中确认表单字段名:
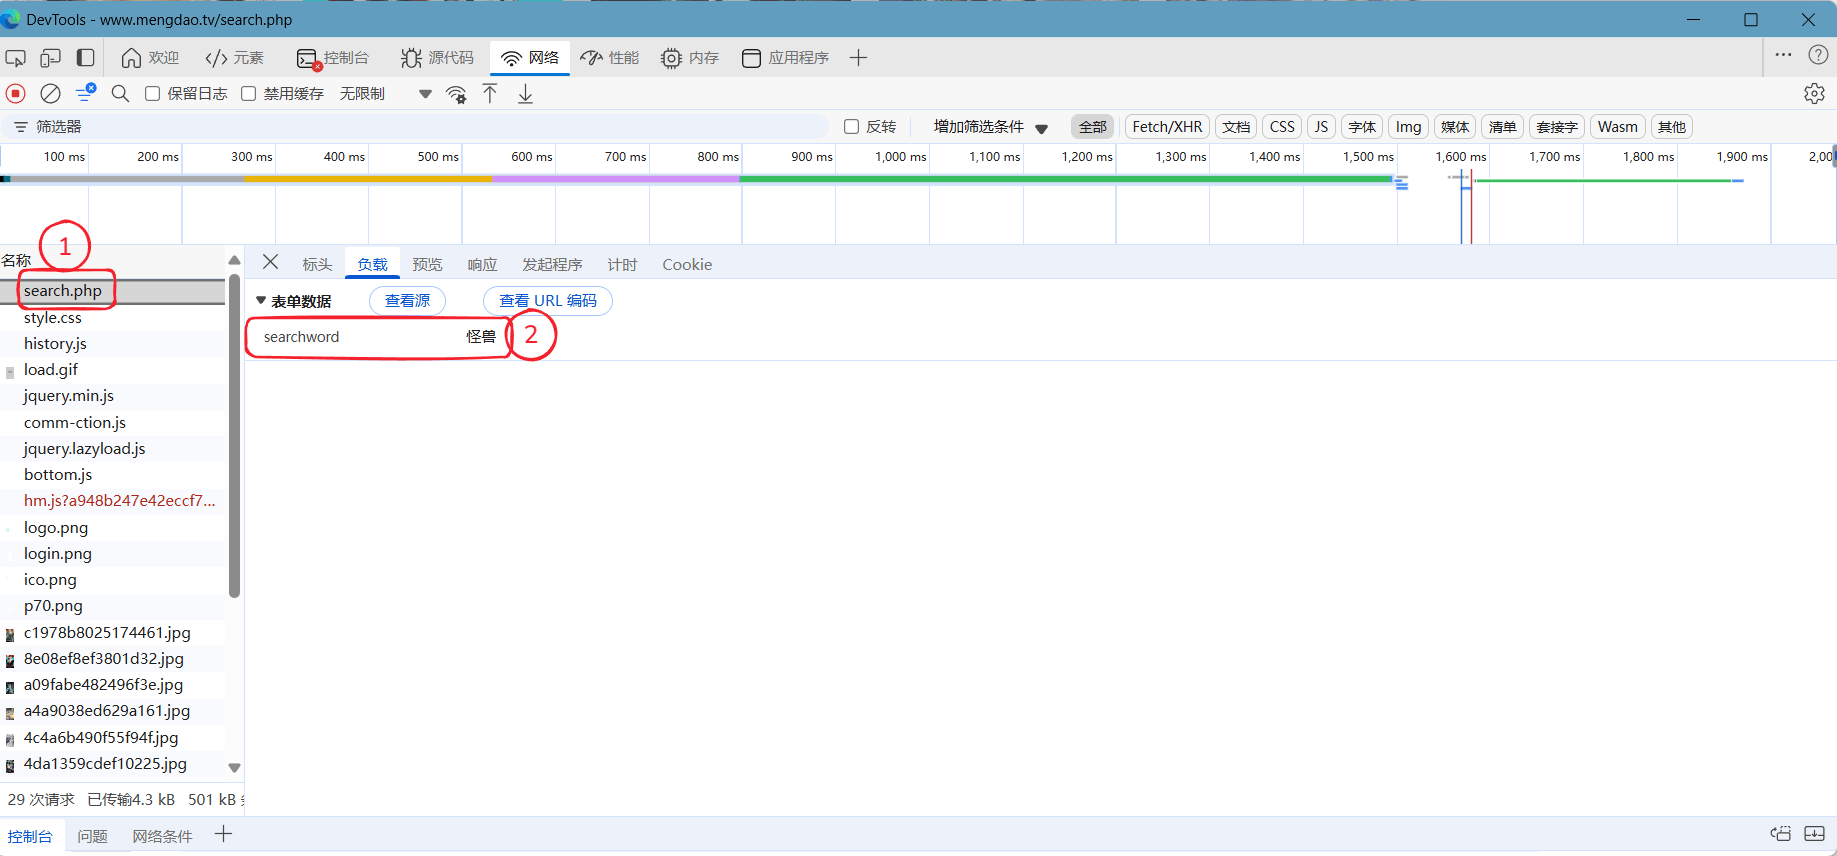
本例的关键词字段为 searchword:
在樱花动漫中将搜索请求方法设为 POST,并把字段及占位变量写入 SearchURL:
执行规则时,樱花动漫会移除 URL 查询部分,并将 searchword 作为表单字段提交。
网站阻止打开开发者工具
如果网站拦截快捷键或检测停靠式开发者工具,可以依次尝试:
- 在空白标签页中通过浏览器菜单打开开发者工具,再访问目标网站。
- 将开发者工具切换为独立窗口,避免网页尺寸变化触发检测。
- 使用单独的浏览器配置文件进行分析,避免影响日常浏览数据。
- 如需安装用于解除限制的扩展或用户脚本,应核对来源和权限,不要在包含账号或敏感 Cookie 的浏览器配置中运行未经审查的脚本。
若网站仍持续跳转或返回验证页,应优先选择结构更稳定、无需复杂验证的来源,或改用其公开 JSON 接口编写 API 规则。
验证与反爬配置(樱花动漫扩展)
樱花动漫 fork 已在内置规则模型之上扩展了登录验证能力:新增 needLogin / loginURL 两个字段,用于标记“本规则必须登录后才能搜索 / 播放”。反爬配置 antiCrawlerConfig 中,验证方式的字段名为 captchaType(而非 mode)。XPath 规则可配置的请求头仅有根级 userAgent 与 referer 两个字段。
登录验证(needLogin / loginURL)
先给结论
官方规则模型中没有 needLogin、loginURL 字段。官方文档对“需要登录”的原话是:
在目标网站中使用任意作品名称执行搜索,确认网站能够直接返回结果。若搜索前必须登录、完成验证码或经过复杂的人机验证,需要额外配置 Cookie 或反爬虫验证,不属于本教程的基础流程。
即官方版规则 JSON 本身不描述登录流程。樱花动漫 fork 已在此基础上内置登录验证支持:插件模型新增 needLogin、loginURL 两个扩展字段,用于标记“本规则必须登录后才能搜索 / 播放”。这两个字段是 fork 既有扩展,不属于官方字段。
字段说明
| JSON 键 | 类型 | 默认值 | 说明 |
|---|---|---|---|
needLogin | bool | false | 为 true 时表示本规则需要登录验证 |
loginURL | string | "" | 登录页地址。解析时兼容旧键名 loginUrl,序列化时统一写回 loginURL |
行为说明
- 执行搜索时,若
needLogin == true且该插件尚未保存有效 Cookie,搜索直接被拦截,不发起任何网络请求;插件状态被标记为“需要登录”。 - 用户在插件页触发登录后,应用通过内置 WebView 打开
loginURL加载登录页。 - 用户在 WebView 内完成登录、页面发生跳转后,应用抓取该 WebView 中的 Cookie,并以插件名为键保存;之后该插件的搜索、观看请求自动携带这些 Cookie。
- Cookie 有效期由规则设置中的天数控制,可在规则设置中调整;过期后视同“未登录”,再次触发拦截,需重新走 WebView 登录。具体默认天数与清理入口以客户端实际为准。
- MCP 服务的字段白名单已把
needLogin、loginURL列为“本 App 扩展字段”。
不要在规则 JSON 里硬编码账号密码:登录动作由用户在 WebView 里人工完成,规则只声明“需要登录 + 登录页地址”,Cookie 由应用托管、按插件名保存在本机,不会随规则文件泄露。
完整可抄示例(XPath 规则)
{
  "api": "1",
  "type": "anime",
  "name": "示例需登录站点",
  "version": "1.0",
  "baseURL": "https://login-required.example.com/",
  "needLogin": true,
  "loginURL": "https://login-required.example.com/login",
  "searchURL": "https://login-required.example.com/search?wd=@keyword",
  "searchList": "//div[@class='search-item']",
  "searchName": "//h3/a",
  "searchResult": "//h3/a",
  "chapterRoads": "//div[@class='playlist-box']",
  "chapterResult": "//ul/li/a",
  "userAgent": "",
  "referer": "https://login-required.example.com/",
  "searchMode": "xpath",
  "chapterMode": "xpath",
  "antiCrawlerConfig": {
    "enabled": false,
    "captchaType": 1,
    "captchaImage": "",
    "captchaInput": "",
    "captchaButton": "",
    "captchaDetectType": 1,
    "captchaDetectValue": "",
    "captchaScript": ""
  }
}loginURL填站点实际的登录页地址;若站点登录入口在首页弹窗而非独立/login页,也可以填首页地址——应用只是用 WebView 打开它,并在登录完成跳转后抓取 Cookie。- 规则导入后首次搜索会显示“需要登录”,点进去在 WebView 里完成登录即可;之后该插件名下的 Cookie 自动生效,无需再改 JSON。
- Cookie 有有效期:过期后搜索会被重新拦回“需要登录”状态,重新打开登录页登录一次即可,不需要修改规则 JSON。
- Cookie 是个人会话凭据,按插件名保存在本机;不要把他人导出的 Cookie 或登录态带进自己的规则。
验证码与反爬(antiCrawlerConfig)
反爬虫配置 antiCrawlerConfig 挂在规则根级,仅在 XPath 搜索阶段被拦截时生效。官方文档原文称:“反反爬虫:用于 XPath 搜索响应被验证页替代的情况。应根据网站实际验证方式配置检测条件和交互步骤。”
字段总表
字段名以规则校验器的实际实现为准(注意:验证方式字段叫 captchaType,不叫 mode):
| 字段 | 类型 | 含义 |
|---|---|---|
enabled | bool | 是否启用反爬配置 |
captchaType | int (1/2/3) | 验证方式:1=图片验证码,2=自动点击,3=自定义 JS |
captchaDetectType | int (1/2/3) | 拦截检测方式:1=XPath 检测节点存在,2=文本匹配,3=正则匹配 |
captchaDetectValue | string | 检测表达式 / 特征文本 / 正则 |
captchaImage | string (XPath) | 图片验证码图片节点定位 |
captchaInput | string (XPath) | 验证码输入框节点定位 |
captchaButton | string (XPath) | 提交按钮节点定位 |
captchaScript | string | captchaType=3 时执行的自定义 JS |
校验器硬性约束:captchaType 与 captchaDetectType 只能取 1、2、3,否则报 must be 1, 2, or 3。
captchaType=1 图片验证码
适用场景:搜索请求返回的不是结果列表,而是一个带图形验证码的页面,需要展示图片、人工(或接打码服务)输入后提交。
{
  "api": "1",
  "type": "anime",
  "name": "示例图片验证码站点",
  "version": "1.0",
  "baseURL": "https://captcha-demo.example.com/",
  "searchURL": "https://captcha-demo.example.com/search?wd=@keyword",
  "searchList": "//div[@class='search-item']",
  "searchName": "//h3/a",
  "searchResult": "//h3/a",
  "chapterRoads": "//div[@class='playlist-box']",
  "chapterResult": "//ul/li/a",
  "searchMode": "xpath",
  "chapterMode": "xpath",
  "antiCrawlerConfig": {
    "enabled": true,
    "captchaType": 1,
    "captchaDetectType": 2,
    "captchaDetectValue": "请输入验证码",
    "captchaImage": "//img[@id='captcha_img']",
    "captchaInput": "//input[@name='captcha']",
    "captchaButton": "//button[@id='submit_btn']",
    "captchaScript": ""
  }
}
captchaDetectType: 2+captchaDetectValue: "请输入验证码"表示:当搜索响应页面中包含「请输入验证码」这段文字时,判定为被拦截。- 命中拦截后,应用用
captchaImage取出验证码图片展示出来,等用户输入后填入captchaInput,再点击captchaButton提交。 captchaDetectType: 1时captchaDetectValue写 XPath(如//form[@id='captcha-form']),页面存在该节点即判定拦截;captchaDetectType: 3时写正则。
captchaType=2 自动点击
适用场景:拦截页只是一个“点击按钮继续 / 我不是机器人”的过渡页,不需要输入字符,自动点一下按钮就能放行。
{
  "api": "1",
  "type": "anime",
  "name": "示例点击验证站点",
  "version": "1.0",
  "baseURL": "https://click-demo.example.com/",
  "searchURL": "https://click-demo.example.com/search?wd=@keyword",
  "searchList": "//div[@class='search-item']",
  "searchName": "//h3/a",
  "searchResult": "//h3/a",
  "chapterRoads": "//div[@class='playlist-box']",
  "chapterResult": "//ul/li/a",
  "searchMode": "xpath",
  "chapterMode": "xpath",
  "antiCrawlerConfig": {
    "enabled": true,
    "captchaType": 2,
    "captchaDetectType": 1,
    "captchaDetectValue": "//div[@id='check-wrap']",
    "captchaImage": "",
    "captchaInput": "",
    "captchaButton": "//button[@id='pass-check']",
    "captchaScript": ""
  }
}
captchaType: 2时不需要captchaImage/captchaInput,只需要把captchaButton指向那个“放行”按钮。- 检测条件这里用
captchaDetectType: 1(XPath 节点存在):页面出现#check-wrap滑块 / 过场容器时,自动点击#pass-check。 - 自动点击对“点一下就放行”的轻量过场有效;对真正的滑块拼图、点选文字等强人机验证无效,那种站点建议换源。
captchaType=3 自定义 JS
适用场景:拦截页需要执行一段页面内脚本(比如调用页面自带的 JS 函数、操作 cookie、跳转特定 URL)才能放行。
{
  "api": "1",
  "type": "anime",
  "name": "示例JS验证站点",
  "version": "1.0",
  "baseURL": "https://jscheck-demo.example.com/",
  "searchURL": "https://jscheck-demo.example.com/search?wd=@keyword",
  "searchList": "//div[@class='search-item']",
  "searchName": "//h3/a",
  "searchResult": "//h3/a",
  "chapterRoads": "//div[@class='playlist-box']",
  "chapterResult": "//ul/li/a",
  "searchMode": "xpath",
  "chapterMode": "xpath",
  "antiCrawlerConfig": {
    "enabled": true,
    "captchaType": 3,
    "captchaDetectType": 3,
    "captchaDetectValue": "challenge\\.js|安全验证",
    "captchaImage": "",
    "captchaInput": "",
    "captchaButton": "",
    "captchaScript": "document.cookie='pass=ok;path=/';location.reload();"
  }
}
captchaType: 3时,命中拦截后应用在该页面 WebView 上下文里执行captchaScript这段 JS。- 这里
captchaDetectType: 3是正则匹配,页面 HTML 里出现challenge.js或「安全验证」字样即触发。 - 脚本怎么写取决于站点拦截页的实际逻辑:常见套路是种一个放行 cookie 后
location.reload(),或调用页面已有的验证函数。拿不准的 API 就先在浏览器 Console 里手工跑通再抄进来。
关闭反爬配置
不需要反爬时保留默认骨架即可(enabled: false,其余字段空串),不要整段删掉——完整规则骨架里始终带这个对象:
"antiCrawlerConfig": {
  "enabled": false,
  "captchaType": 1,
  "captchaImage": "",
  "captchaInput": "",
  "captchaButton": "",
  "captchaDetectType": 1,
  "captchaDetectValue": "",
  "captchaScript": ""
}
请求头与验证的配合(userAgent / referer)
规则编辑器“高级选项”中的说明:
User-Agent:覆盖播放器和下载器请求中的浏览器身份标识。一般留空;只有来源校验特定 User-Agent 时才需要填写。
Referer:覆盖播放器和下载器请求中的来源页面。若媒体服务器校验来源,可以填写规则的基础地址或实际要求的页面地址。
对应到 JSON 就是两个根级字段:
{
  "userAgent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/126.0.0.0 Safari/537.36",
  "referer": "https://www.example.com/"
}- 未显式指定 UA 时,应用会用一个内置的桌面浏览器 UA 兜底;你填了
userAgent就以你填的为准。 - 当请求没有自带
Referer头时,应用会自动补上referer字段的值。
与登录 / 验证码配合时的注意点:
- UA 要和你抓包时的浏览器 UA 保持一致。登录态 Cookie 经常和 UA 绑定(服务端会校验),规则里 UA 乱写可能导致“Cookie 明明有效却被踢回登录页”。
- Referer 往往是反爬放行的关键。不少站点的验证码接口、搜索接口只校验
Referer是否来自自己域名。curl 复现时如果不带 Referer 返回 403/验证页,带上referer: https://站点域名/再试。 - API 模式下请求级
headers优先级高于根级userAgent/referer:你在request.headers里显式写了User-Agent或Referer,就按你写的来;没写才回落根级配置。
自定义请求头现状
当前规则模型中没有通用的自定义请求头(headers / customHeaders)字段。规则作者能够配置的请求头相关项只有两个根级字段:
| 字段 | 作用 |
|---|---|
userAgent | 覆盖请求、播放器与下载器的浏览器身份标识,用于模拟正常浏览器环境 |
referer | 标注请求的来源页面,用于通过站点的防盗链 / 来源校验 |
满足反爬要求时,请优先通过这两个字段解决:
- 用
userAgent模拟浏览器环境:填写一个真实桌面浏览器的 UA 字符串(如最新版 Chrome 的 UA)。不要留空使用兜底 UA,也不要填带有明显爬虫特征的字符串(如Python-urllib、curl/...)。 - 用
referer标注来源页:填写站点根地址或实际要求的页面地址(通常取baseURL,或抓包时看到的 Referer 值)。很多站点的搜索接口、媒体资源只校验Referer是否来自自家域名,补上即可放行。
{
  "userAgent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/126.0.0.0 Safari/537.36",
  "referer": "https://www.example.com/"
}
如果站点除 UA / Referer 之外还强制要求其他请求头(如自定义 Token、CSRF 头)或登录 Cookie,当前规则模型没有对应配置入口:请优先选择不校验这些头的公开接口 / 来源,或更换无需此类校验的站点。
常见坑
- 验证码图片怎么取 / 怎么下载:
captchaImage填的是 XPath,指向验证码<img>节点,由应用在 WebView 里取出展示,不需要你在 JSON 里手写图片 URL。如果你用 curl 调试验证码接口,注意验证码图片通常和验证页面共享同一个会话 Cookie——直接下载图片地址而不带刚才拿到的 Cookie,拿到的是另一张图,永远对不上。 - Cookie 过期:登录态站点的会话 Cookie 一般几小时到几天过期。表现为“昨天还好,今天搜索全空 / 全跳登录页”。在樱花动漫中可重新在插件登录页走 WebView 登录一次,应用会重新抓取并保存 Cookie。不要把长期不失效的 Cookie 当成永久凭据。
- 302 跳转:探测脚本会自动跟随 302/301,并把响应里的
Set-Cookie收进会话 jar、后续请求自动回传。但如果你的“搜索结果”其实是 302 跳到了一个登录页 / 验证页,searchList会匹配到 0 条——这时要检查的是“被谁拦了”,而不是 XPath 写错了。 - 反爬配置只对 XPath 搜索阶段生效:
antiCrawlerConfig管的是“搜索那一下”被验证页替换的情况;选集阶段、播放页阶段被拦,它管不到。API 模式的请求被 403 / 拦截,要去补 API 请求request.headers里的 Referer / UA,而不是去开antiCrawlerConfig。 captchaType不是mode:字段名是captchaType,检测类型是captchaDetectType,两个都只能取 1/2/3。写成"mode": 1校验器不认。- 敏感信息泄露:Cookie、Token、Authorization、CSRF 一律不要提交到公开规则仓库;校验器会把这些键在报告里脱敏,但你贴进文档 / 群聊的规则 JSON 不会自动脱敏,发出去前自己先替换。
- 强人机验证(滑块、点选、Cloudflare Turnstile)不要硬刚:官方文档明确建议,遇到这类无法复现的前端加密 / 强验证,应“优先选择结构更稳定、无需复杂验证的来源,或改用其公开 JSON 接口”。
- API 请求相关 JSON 必须合法:官方文档“常见错误”里专门列了「请求头、查询参数、响应变量和播放页查询参数都必须是合法 JSON 对象,键名和字符串使用双引号,末尾不要加多余逗号」。
本节内容依据樱花动漫 fork 规则模型(needLogin / loginURL 扩展字段、antiCrawlerConfig 校验器实现)与 Kazumi 官方规则文档(XPath 规则开发、API 规则开发,官方来源)整理;标注为经验的条目来自规则调试实践,非官方原文。
樱花动漫文档 · 规则格式兼容 Kazumi